其实这期是用来回顾我做过的一个项目的。
现在开始吧
客户端
技术栈:C++17 / Qt 6.5 / FFmpeg 8.0 / OpenGL 3.3 Core / miniaudio / QOpenGLWidget
整体的文件结构:
RinzePlayer/
├─ main.cpp                    // 入口:QApplication + MainWindow 装配
├─ core/       MediaController            // 播放编排中枢(唯一对外控制面)
├─ demux/      Demux                      // FFmpeg 解封装线程 + 低延迟参数配置
├─ decode/     DecodeBase(抽象)          // 解码基类:线程/队列/序列号/EOF
│           ├─ DecodeVideo   // FFmpeg filter graph + libplacebo(Vulkan) 路径
│           ├─ DecodeAudio
│           └─ DecodeSubtitle
├─ renderer/   VideoPlayer / AudioPlayer  // 帧消费:节奏控制 / PCM 写入
│           ├─ VideoRenderData / SubRenderData // 渲染数据 + 原子双缓冲
│           ├─ VideoRenderer // QQuickFramebufferObject::Renderer(QML FBO 版,当前未接线)
│           └─ VideoWindow   // QML FBO item,当前未接线
├─ clock/      GlobalClock + Clock        // 三时钟(音频/视频/外部)+ 主时钟
├─ streaming/  StreamManager              // 协议识别 / 退避重连 / 缓冲监控
├─ utils/      SPSCBuffer / SPSCQueue     // 无锁环形队列(字节型 / 模板型)
│           └─ AtomicDoubleBuffer // 状态位双缓冲
├─ audioeffects/ AudioEffect(抽象)        // 效果器基类 + 工厂
│           ├─ AudioMixer    // 效果器链容器(混音器)
│           └─ effects/ equalizer · graphiceq · reverb
├─ visualizer/ FFT 频谱 + 粒子着色器
├─ ui/         MainWindow / VideoWidget / HoverControlBar / PiPWindow
│           └─ VideoWidget // QOpenGLWidget:纹理上传 / 变换 / 字幕叠加 / 运动向量
└─ resource/   shader.vert·frag(视频)· motion_vector.vert·geom·frag(运动向量)
             · visualizer_spectrum.* · visualizer_particle.*
总共分为**核心 解复用 解码 渲染 时钟 流媒体** 六大部分。
文档分两层:上面「六大部分」是每一块的概览(一句话说明 + 结构图),下面「## 拆解」按模块逐个展开到函数与数据链路。
- 核心 →
### 一、Core - 解复用 →
### 二、Demux - 解码 →
### 三、解码 - 渲染 →
### 四、渲染 - 时钟 →
### 五、时钟 - 流媒体 →
### 六、流媒体
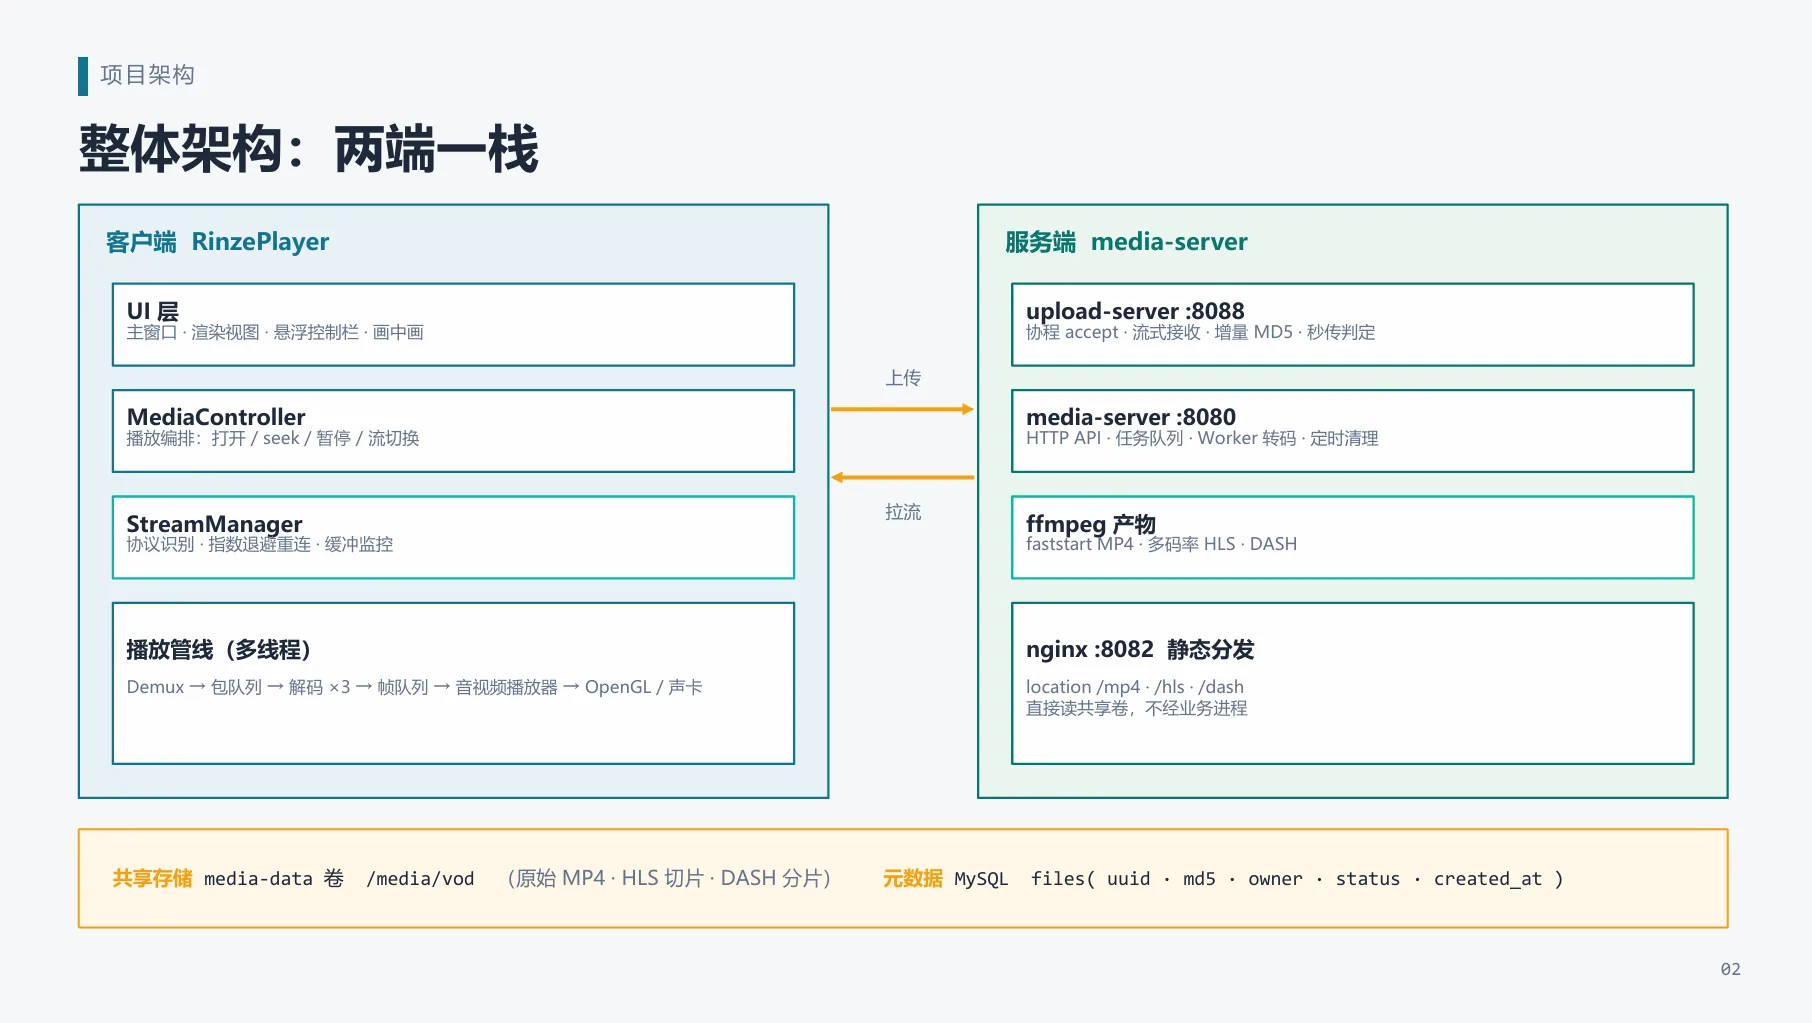
核心
暴露 open/seek/播放控制接口;持有全部队列;串联 Demux、解码、播放、渲染
我们先亮出mermaid。
展开图表
时序图
展开图表
解复用
展开图表
数据流
展开图表
解码
三路解码各起一个线程;从包队列取包,用 serial 判断新旧,解出的帧再塞进帧队列
展开图表
数据流
展开图表
渲染
VideoPlayer/AudioPlayer 各自消费帧队列;视频经原子双缓冲交给 QOpenGLWidget 上屏,音频重采样成 PCM 写进无锁环形缓冲
展开图表
这一节先把链路说清楚:帧从队列到屏幕要跨三个线程。
[帧队列]->[VideoPlayer 节奏与数据准备]->[原子双缓冲发布]->[Qt 排队到 GUI 线程]->[VideoWidget::paintGL 上传纹理]->[FBO 上屏]
解码线程只负责把帧塞进帧队列;播放线程(VideoPlayer 自己那根 std::thread)负责把帧整理成能直接上传的形态、并决定这一帧该等多久;真正的 GL 调用在 GUI 线程的 paintGL() 里。三个线程之间没有锁,交接全靠一条队列和一对双缓冲。
逐段拆解见「## 拆解」的「四、渲染」。
时钟
三个 Clock(音频/视频/外部)由一个单例 GlobalClock 持有,主时钟决定“现在第几秒”
展开图表
逐段拆解见「## 拆解」的「五、时钟」。
流媒体
StreamManager 负责协议识别、状态机、指数退避重连和缓冲水位估算,本地文件走同一套状态机
展开图表
展开图表
逐段拆解见「## 拆解」的「六、流媒体」。
拆解
一、Core
对于Core部分,首要的就是MediaController,它是整个项目的控制核心。
前文的mermaid里说明它掌控了解复用、解码、音视频解码播放,时钟等部分,状态采集是额外的部分。
展开图表
通常来说,这种模式叫做Facade + Mediator(编排者)+ Composition,对外它是唯一控制中枢,对内它替子系统决定谁先谁后、谁跟谁绑定(队列绑定)、什么时候换time_base。
在构造函数里,进行了成员部分的初始化。
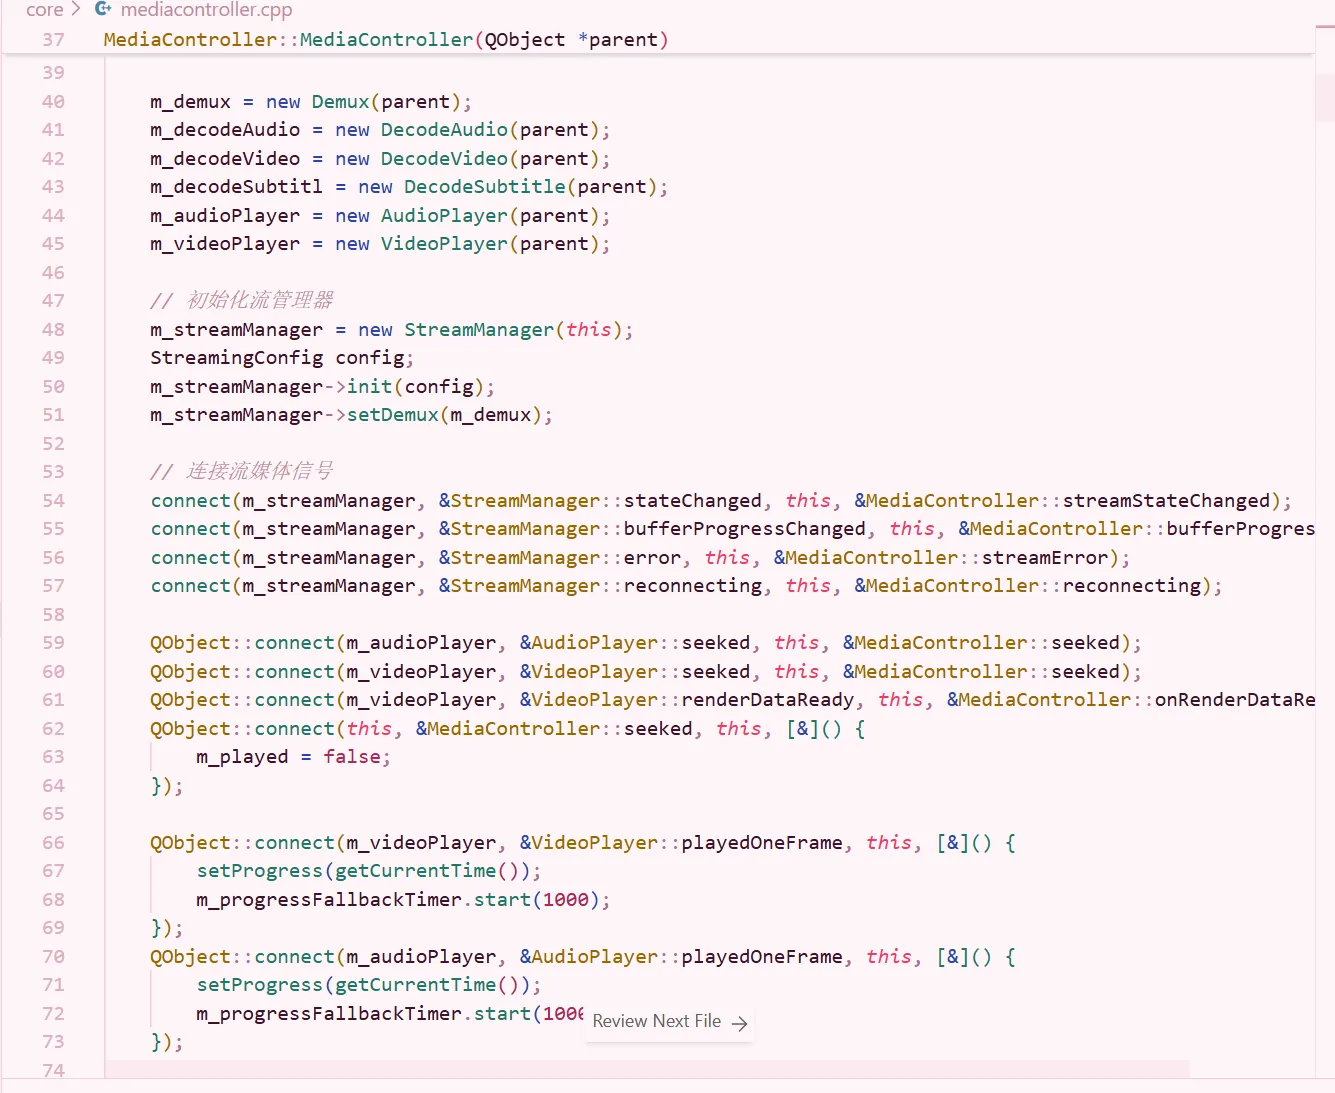
我们从截图可以看到构造里的槽函数,用流管理器的信号去链接媒体管理器的槽函数,在媒体管理器构造时期就做好了绑定,实现了两个部分的耦合。
再就是seek、render的操作也进行了绑定,基础地使得媒体管理器作为一切的控制中枢。
MediaController::open(const QUrl &URL)
这部分是媒体管理器的核心部分,它从QUrl来获取媒体的路径。
媒体都可以抽象为url,就像这样
- 文件:/path/to/your/mediafile
- 网络音视频流:流媒体协议:/xxx/xxx{.m3u8;.mp4…}
在打开媒体的时候,我们会判断它是本地媒体文件,还是网络流媒体,这就导致我们需要不同的策略去处理它。
-
媒体文件
-
我们会判断媒体文件的真实性(解复用尝试解析,看是否为媒体文件,并返回结果),如果非可用,我们会返回一个不可用的结果,会close流。
// 本地文件同步打开,网络流异步打开不阻塞UI if (URL.isLocalFile()) { bool ok = true; qDebug() << "调用Demux::init,传递的路径:" << openPath; ok &= m_demux->init(openPath.toUtf8().constData(), true); if (!ok) { QString error = QString("无法解析媒体文件: %1").arg(openPath); qDebug() << "Demux初始化失败!"; m_streamManager->onDemuxError("Failed to initialize demux for: " + openPath); close(); return false; } -
在判断可用后,我们会让demux选择对应的音视频buf,基于buffer进行初始化(init),并判断音频视频流是否可用,并返回可用结果
-
初始化成功后,我们会让Device部分设定这个流的A/V(音、视频)流的可用性。
-
初始化成功后,我们会让媒体管理器设置Duration(时长),进度(0)
-
初始化成功后,初始化全局时钟,根据设备状态(DeviceStatus对应流的可用状态)来初始化时钟。
-
正式进行时钟初始化:
        GlobalClock::instance().reset();
        // 有音频时主时钟为Audio,否则为Video
        GlobalClock::instance().setMainClockType(haveAudio ? ClockType::AUDIO : ClockType::VIDEO);
我们策略上是会以音频时钟为主时钟,逐步做降级策略。
-
在时钟初始化完毕,一切准备就绪:
ok &= m_videoPlayer->init(m_frmVideoBuf, m_frmSubtitleBuf);
        if (!ok) {
            close();
            return false;
        }

        m_demux->start();
        m_decodeAudio->start();
        m_decodeVideo->start();
        m_decodeSubtitl->start();
        m_audioPlayer->start();
        m_videoPlayer->start();
// 启动启动所有单位全部启动!
-
-
网络流
-
网络流和本地文件策略不太相同: 网络流:先快速返回,不阻塞UI,异步调用实际的打开
先是返回ok,然后再异步调用
        // 网络流:先快速返回,不阻塞UI,异步调用实际的打开
        QMetaObject::invokeMethod(this, [this, openPath]() {
            bool ok = true;
			....和上方一样的处理模式
        }, Qt::QueuedConnection);
使用
Qt::QueuedConnection跨线程枚举来实现异步,在途中如果遇到问题,直接return,All passed才会return true
-
bool MediaController::close()
这部分是所有涉及到关闭的操作。
    // 关闭流管理器
    m_streamManager->close();

    bool ok = true;
    ok &= m_demux->uninit();
    ok &= m_decodeAudio->uninit();
    ok &= m_decodeVideo->uninit();
    ok &= m_decodeSubtitl->uninit();
    ok &= m_audioPlayer->uninit();
    ok &= m_videoPlayer->uninit();
    clearPktQ(m_pktAudioBuf);
    clearPktQ(m_pktVideoBuf);
    clearPktQ(m_pktSubtitleBuf);
    clearFrmQ(m_frmAudioBuf);
    clearFrmQ(m_frmVideoBuf);
    clearFrmQ(m_frmSubtitleBuf);
    DeviceStatus::instance().setHaveAudio(false);
    DeviceStatus::instance().setHaveVideo(false);
    GlobalClock::instance().reset();
    setOpened(false);
    m_currentVideoStream = {-1, -1};
    m_currentAudioStream = {-1, -1};
    m_currentSubtitleStream = {-1, -1};
    setPaused(true);
    setDuration(0);
    setProgress(0);
    PlaybackStats::instance().reset();
    qDebug() << "关闭";
    emit chaptersInfoUpdate();
    return ok;
直接是一个流水的关闭所有开启的模块,完成close。
暂停
媒体管理器的职责之一就是处理seek与暂停等合适的业务情况。
/**
 * @brief 切换暂停状态
 *
 * 同时驱动视频播放器、音频播放器与全局时钟,随后更新 m_paused;
 * 若同步处于激活状态,会把本次操作(含当前位置)上报给 SyncManager。
 */
void MediaController::togglePaused() {
    if (!m_opened) {
        return;
    }
    m_videoPlayer->togglePaused();
    m_audioPlayer->togglePaused();
    GlobalClock::instance().togglePaused();
    setPaused(!m_paused);

    // Sync hook
    if (m_syncManager && m_syncManager->isSyncing()) {
        double pos = getCurrentTime();
        if (m_paused) {
            m_syncManager->onLocalPause(pos);
        } else {
            m_syncManager->onLocalPlay(pos);
        }
        if (m_roomSession) {
            // 事件已由 Server 统一记录
        }
    }
}
当用户点击暂停按钮后,信号槽链路会落到这里,进行统一的暂停处理。
Seek
/**
 * @brief 执行一次 seek,不做任何上报
 * @param ts 目标位置(秒)或相对偏移
 * @param rel 相对偏移模式:0 表示绝对定位并夹到 [0, duration],非 0 表示相对跳转
 */
void MediaController::seekInternal(double ts, double rel) {
    if (!m_opened) return;
    double safeTs = ts;
    if (rel == 0.0) {
        safeTs = std::max(0.0, std::min(safeTs, static_cast<double>(m_duration)));
    }
    m_demux->seekBySec(safeTs, rel);
}

/**
 * @brief 用户发起的 seek
 * @param ts 目标位置(秒)或相对偏移
 * @param rel 相对偏移模式,含义同 seekInternal
 * @note 只有绝对定位(rel 为 0)且同步激活时才上报,快进快退传 ±5 因此不会扩散
 */
void MediaController::seekBySec(double ts, double rel) {
    seekInternal(ts, rel);
    // 只对用户主动的绝对 seek 广播
    if (rel == 0.0 && m_syncManager && m_syncManager->isSyncing()) {
        double safeTs = std::max(0.0, std::min(ts, static_cast<double>(m_duration)));
        m_syncManager->onLocalSeek(safeTs);
    }
}
具体的seek操作要在demux环节来完成。
二、Demux
demux(解复用)作为音视频解码链路的首段,处于一个很重要的地位。
[Demux]->[Decode]->[Render]
它的职责在于把源拆解成FFmpeg可识别的独立单元包。
初始化:init
函数签名:bool Demux::init(const std::string URL, bool isMainDemux)
-
首先我们创建
AVDictionary* opts = nullptr;很清晰的可以看出来
AVDictionary中 Dict与变量的opt意思,意为参数集 -
在这之后,调用
int ret = avformat_open_input(&m_formatCtx, URL.c_str(), nullptr, &opts);avformat_open_input的作用是,从格式上下文,C-Style风格流媒体url字符串,opts集来进行解封装。在解封装之后进行
av_dict_free(&opts);目的是释放参数集上下文。 -
此外
FFmpeg拥有C库一贯而言的机制,都是基于上下文的概念来开发的。if (ret != 0) { av_strerror(ret, errBuf, 512); qDebug() << errBuf; return false; }从操作函数里返回ret码,根据ret码判断成功与否,例如这个就是,0为默认的success值,非0就要进行错误兜底,这里就可以看出来,调用
av_strerror(ret, errBuf, 512);来填充err信息。 -
设定最大帧间隔:为音视频同步逻辑提供一个“可信”的帧时长阈值,用来判断从时间戳(PTS)计算出的帧间隔是否合理,从而避免因数据流中的时间戳跳变(discontinuity)导致播放卡顿或同步崩溃。
    double maxFrameDuration = (m_formatCtx->iformat->flags & AVFMT_TS_DISCONT) ? 10.0 : 3600.0;
    GlobalClock::instance().setMaxFrameDuration(maxFrameDuration);
相关位运算在这里:
AVFMT_TS_DISCONT是定义在libavformat/avformat.h头文件中的一个宏常量。#define AVFMT_TS_DISCONT 0x0200 /**< Format allows timestamp discontinuities. Note, muxers always require valid (monotone) timestamps */- 含义:该格式允许时间戳出现不连续(跳变)。这通常用于 HLS、MPEG-TS 等流媒体格式,它们可能在广告插入或流切换时产生时间戳断层。
m_formatCtx->iformat指向的是一个AVInputFormat结构体,它描述了特定输入格式的解封装器。其
flags字段的定义如下:int flags; /**< Can use flags: AVFMT_NOFILE, AVFMT_NEEDNUMBER, AVFMT_SHOW_IDS, AVFMT_GENERIC_INDEX, AVFMT_TS_DISCONT, AVFMT_NOBINSEARCH, AVFMT_NOGENSEARCH, AVFMT_NO_BYTE_SEEK, AVFMT_SEEK_TO_PTS. */- 设置时钟
MaxFrameDuration:作用是判断从时间戳(PTS)差值计算出的帧持续时间是否“可信”,以此来保护主时钟的同步基准不被异常数据污染。 - 带有
AVFMT_TS_DISCONT(如 HLS/MPEG-TS):阈值设为 10 秒。这类流天生允许时间戳跳变,所以校验标准非常严格。任何超过 10 秒的 PTS 差值都会被直接判定为“跳变”,不予采信。 - 不带该标志(如本地 MP4/MKV):阈值放宽到 3600 秒(1小时)。这类文件的时间戳通常是连续可靠的,允许存在长间隔的帧(例如幻灯片式的视频或极低帧率的画面),因此校验标准可以非常宽松
-
读取源头流信息,然后填充到
m_formatCtx中。// 读取媒体文件的流信息 ret = avformat_find_stream_info(m_formatCtx, nullptr); if (ret < 0) { av_strerror(ret, errBuf, 512); qDebug() << errBuf; avformat_close_input(&m_formatCtx); return false; } -
获取流index
    // 获取各种流的idx
    for (unsigned int i = 0; i < m_formatCtx->nb_streams; ++i) {
        AVMediaType sType = m_formatCtx->streams[i]->codecpar->codec_type;
        if (sType == AVMEDIA_TYPE_VIDEO)
            m_videoIdx.push_back(i);
        else if (sType == AVMEDIA_TYPE_AUDIO)
            m_audioIdx.push_back(i);
        else if (sType == AVMEDIA_TYPE_SUBTITLE)
            m_subtitleIdx.push_back(i);
    }
遍历格式上下文的所有流信息,推送到音视频的索引
vector里。
开始读包
/**
 * @brief 启动读包线程
 * @note 幂等:线程已在运行时直接返回
 */
void Demux::start() {
    if (m_thread.joinable()) {
        return; // 已经在运行了
    }
    m_stop.store(false, std::memory_order_relaxed);
    m_thread = std::thread([this]() {
        demuxLoop();
    });
}
采用std::thread,以decodeLoop为挂在函数开创线程。
demuxLoop
函数签名:void Demux::demuxLoop()
- 建立可复用的
AVPacket:AVPacket *pkt = nullptr; - 进入循环:
while (!m_stop.load(std::memory_order_relaxed))
如果需要Seek:
if (m_needSeek.load(std::memory_order_acquire)) {
          	seekAllPktQueue();
            int streamIdx = m_isMainDemux ? -1 : (m_usedVIdx != -1) ? m_usedVIdx.load()
                                             : (m_usedAIdx != -1)   ? m_usedAIdx.load()
                                                                    : m_usedSIdx.load();
            double time_base = streamIdx == -1 ? 1.0 / AV_TIME_BASE : av_q2d(m_formatCtx->streams[streamIdx]->time_base);
            double target = m_seekTs / time_base;
            int64_t seekMin = m_seekRel > 0.0 ? static_cast<int64_t>(target - m_seekRel * AV_TIME_BASE + 2) : INT64_MIN;
            int64_t seekMax = m_seekRel < 0.0 ? static_cast<int64_t>(target - m_seekRel * AV_TIME_BASE - 2) : INT64_MAX;
            int ret = avformat_seek_file(m_formatCtx, streamIdx, seekMin, target, seekMax,
                                         m_usedVIdx == -1 ? AVSEEK_FLAG_ANY : 0);
            if (ret < 0) {
                qDebug() << "seek出错";
            }
            emitRealSeekTs = m_isMainDemux;
            m_needSeek.store(false, std::memory_order_release);
        }
在seek的时候,一般要遵循这样的规则:
[先清理包]->[更新流id]->[计算时间基]->[计算目标seekms{包括理论min,max}]->
[调用]avformat_seek_file(m_formatCtx, streamIdx, seekMin, target, seekMax,
                                         m_usedVIdx == -1 ? AVSEEK_FLAG_ANY : 0);
[Seek完毕:] needseek原子变量置false m_needSeek.store(false, std::memory_order_release);
seekMin和seekMax计算规则:
-
在计算它们之前首先要计算时间基
time_basedouble time_base = streamIdx == -1 ? 1.0 / AV_TIME_BASE : av_q2d(m_formatCtx->streams[streamIdx]->time_base);如果流index为-1,就是用默认
AV_TIME_BASE的倒数,如果不是这种情况就是用流索引的1/2次幂。 -
这样我们就拿到了时间基
time_base,接下来计算seekMin位置和seekMax位置。int64_t seekMin = m_seekRel > 0.0 ? static_cast<int64_t>(target - m_seekRel * AV_TIME_BASE + 2) : INT64_MIN; int64_t seekMax = m_seekRel < 0.0 ? static_cast<int64_t>(target - m_seekRel * AV_TIME_BASE - 2) : INT64_MAX;这里
INT64_MIN和INT64_MAX被当作哨兵值,表示“不限制范围”:seekMin = INT64_MIN:告诉avformat_seek_file,下界不设限制,可以往前任意找。seekMax = INT64_MAX:告诉avformat_seek_file,上界不设限制,可以往后任意找。
m_seekRel的作用:
- 当
m_seekRel > 0时
seekMin = target - m_seekRel * AV_TIME_BASE + 2; seekMax = INT64_MAX;m_seekRel为正,所以target - m_seekRel * AV_TIME_BASE比target小。- 于是
seekMin被设置为一个比目标时间戳更早的值。 seekMax保持INT64_MAX,上界不限制。
结果:允许搜索的范围是
[target - Δ, +∞),其中Δ = m_seekRel * AV_TIME_BASE。 这意味着 允许向前(更早的时间)搜索,且容差大小为Δ。- 当
m_seekRel < 0时
seekMin = INT64_MIN; seekMax = target - m_seekRel * AV_TIME_BASE - 2;m_seekRel为负,- m_seekRel * AV_TIME_BASE变成正数。- 所以
seekMax被设置为一个比目标时间戳更晚的值。 seekMin保持INT64_MIN,下界不限制。
结果:允许搜索的范围是
(-∞, target + |Δ|]。 这意味着 允许向后(更晚的时间)搜索,容差大小同样是|m_seekRel| * AV_TIME_BASE。- 当
m_seekRel == 0时
seekMin = INT64_MIN,seekMax = INT64_MAX,上下界都不限制,完全由avformat_seek_file根据目标时间戳自行寻找最近的关键帧。
开始解复用
	pkt = av_packet_alloc();
        int ret = av_read_frame(m_formatCtx, pkt);
        if (ret < 0) {
            if (ret == AVERROR_EOF && !m_isEOF) { // EOF
                Q_ASSERT(pkt->data == NULL && pkt->size == 0);
                pushVideoPkt(pkt);
                pkt = av_packet_alloc();
                pushSubtitlePkt(pkt);
                pkt = av_packet_alloc();
                pushAudioPkt(pkt);
                pkt = nullptr;
                qDebug() << "解复用EOF";
                m_isEOF = true;
            } else if (ret != AVERROR_EOF) { // error
                qDebug() << "解复用出错";
                goto end;
            }
            std::this_thread::sleep_for(std::chrono::milliseconds(10));
            continue;
        } else {
            m_isEOF = false;
        }
这是一个解复用的流程,我们前面创建了AVPacket* pkt,在这里我们就av_packet_alloc()来创建内存。
此外调用av_read_frame(m_formatCtx, pkt); 来从格式上下文来读一帧,并装载到pkt里。
在ret为负数的时候,先判断是否为AVERROR_EOF:它的核心语义是:对于读操作而言,没有更多数据可用了。
AVERROR_EOF 主要在以下几个关键场景中返回:
- 读取数据包时 (
av_read_frame):当解复用器(demuxer)读到文件或流的末尾时,av_read_frame()会返回AVERROR_EOF,表示不再有新的数据包。这是播放器判断文件播放完毕的主要依据。 - 解码器冲刷(Draining)时:这是现代 FFmpeg 编解码 API 中最重要的用途。为了处理 B 帧等需要缓存的编码格式,在发送完所有数据后,需要进入“冲刷模式”。
- 此时,向
avcodec_send_packet()(解码)或avcodec_send_frame()(编码)发送一个NULL包(或帧)来触发冲刷。 - 然后,循环调用
avcodec_receive_frame()或avcodec_receive_packet()来获取编码器/解码器内部缓存的所有剩余帧/包。 - 这个循环的终止条件,就是当接收函数返回
AVERROR_EOF,表示所有缓存数据都已取出。
- 此时,向
- 输入输出(I/O)层面:在自定义的 I/O 读取回调中,当读操作到达末尾时,也需要返回
AVERROR_EOF,以便上层 FFmpeg 框架能正确识别流已结束。
在这之后,一般会alloc一个空的packet推送给队列,说明这个流程已经结束了,让线程休息10ms避免空转。
三、解码
我们来到了核心部分–解码
├─ decode/
|			|- DecodeBase(抽象)          // 解码基类:线程/队列/序列号/EOF
│           ├─ DecodeVideo   // FFmpeg filter graph + libplacebo(Vulkan) 路径
│           ├─ DecodeAudio
│           └─ DecodeSubtitle
解码基类
我们来到这部分,首先是DecodeBase
它作为基类下发不同类型的解码:such as 音频、视频、字幕解码。
- 初始化
函数签名:bool DecodeBase::init(AVStream *stream, sharedPktQueue pktBuf, sharedFrmQueue frmBuf, int threadNum)
- 其中参数
AVStream*是待填充的音视频流 sharedPktQueue pktBuf, sharedFrmQueue frmBuf, int threadNum分别为pkt缓冲区、帧缓冲区。threadNum是线程数。
	// 错误处理已省略。
	m_streamIdx = stream->index;
    m_codecCtx = avcodec_alloc_context3(nullptr);
    if (!m_codecCtx) {
        qDebug() << "解码器上下文分配失败";
        return false;
    }

    int ret = avcodec_parameters_to_context(m_codecCtx, stream->codecpar);
    if (ret < 0) {
        avcodec_free_context(&m_codecCtx);
    }

    m_codec = avcodec_find_decoder(stream->codecpar->codec_id);
    if (!m_codec) {
        qDebug() << "无合适的解码器";
        return false;
    }

    m_codecCtx->pkt_timebase = stream->time_base;
    m_codecCtx->codec_id = m_codec->id;

    // 设置低延迟标志
    if (m_lowLatencyMode) {
        m_codecCtx->flags |= AV_CODEC_FLAG_LOW_DELAY;
    }


    ret = avcodec_open2(m_codecCtx, m_codec, &opts);
    av_dict_free(&opts);

    if (!pktBuf) {
        qDebug() << "无效pkt队列";
        return false;
    }
    if (!frmBuf) {
        qDebug() << "无效frm队列";
        return false;
    }

    m_pktBuf = pktBuf;
    m_frmBuf = frmBuf;
    m_time_base = stream->time_base;
    m_isEOF = false;
    m_serial = 0;
    return true;
主要流程在于从stream_index拿到对应解码器m_codecctx上下文,再从解码器上下文拿到解码器实例(id),填充各种缓冲区,设立时间基与系列码,返回。
Decode::start()
void DecodeBase::start() {
    if (!m_initialized || m_thread.joinable()) {
        return; // 已经在运行了
    }
    m_stop.store(false, std::memory_order_relaxed);
    m_thread = std::thread([this]() {
        decodingLoop();
    });
}
依旧是采用线程的方式启动解码循环。
四、渲染
目录大概是这样的:
renderer/   VideoPlayer / AudioPlayer  // 帧消费:节奏控制 / PCM 写入
│           ├─ VideoRenderer 			// QML FBO 版渲染实现(当前未接线)
│           ├─ VideoWindow   			// QML FBO item(当前未接线)
│           └─ VideoRenderData / SubRenderData // 渲染数据 + 原子双缓冲
ui/         VideoWidget                     // QOpenGLWidget:纹理上传 / 变换 / 字幕叠加(实际使用)
由VideoPlayer做节流与数据准备、VideoWidget(QOpenGLWidget)承接纹理上传与绘制、RenderData把解码帧整理成能直接上传的形态,三者串起渲染这条链。VideoPlayer 跑在自己的一根线程上,VideoWidget 的 GL 上下文在 GUI 线程,两个线程之间靠一对原子双缓冲交接数据,不做拷贝。
按数据链路来看,视频这一路是这样走的:
展开图表
链路上一共五站,对应下面几节:取帧与节流在 #### VideoPlayer,把帧整理成能上传的形态在 #### RenderData,双缓冲交接在 #### 双缓冲与发布,上传纹理与绘制在 #### VideoWidget,最后是承载这些数据的容器 #### AVFrmItem。
首先我们针对基础的RenderData来介入。
RenderData
struct VideoRenderData {
    enum PixFormat {
        // 可直接上传opengl,通过GLPara获取参数
        NONE = -1,
        RGB_PACKED,
        RGBA_PACKED,

        // 以下类型每个分量独占一个平面
        RGB_PLANAR,
        RGBA_PLANAR,
        Y,
        YA,
        YUV,
        YUVA,
    };

    /**
     * 用于直接上传OpengGL的参数
     * 依次为:internalformat,format,type
     */
    inline static std::map<AVPixelFormat, std::array<unsigned int, 3>> GLParaMap{
        {AV_PIX_FMT_RGB24, {GL_RGB8, GL_RGB, GL_UNSIGNED_BYTE}},                        ///< packed RGB 8:8:8, 24bpp, RGBRGB...
        {AV_PIX_FMT_BGR24, {GL_RGB8, GL_BGR, GL_UNSIGNED_BYTE}},                        ///< packed RGB 8:8:8, 24bpp, BGRBGR...
        {AV_PIX_FMT_BGR8, {GL_R3_G3_B2, GL_RGB, GL_UNSIGNED_BYTE_2_3_3_REV}},
       // 很多种色彩类型,省略了
    };

    AVFrmItem frmItem;
    double renderedTime; // 实际渲染到FBO的时间(相对现实时间,秒)

    PixFormat pixFormat = PixFormat::NONE;

    // 视频信息用于UI显示
    QString pixelFormatName;
    QString colorRangeName;
    QString colorSpaceName;

    // 每个分量按Y|YA|YUV|YUVA|RGB|RGBA的顺序依次排列
    std::vector<std::vector<uint16_t>> dst16{4};
    uint8_t componentBitSize[4]{0, 0, 0, 0}; // 分量的大小(bit)
    // 以下三个数组为OpenGL初始化和更新纹理使用
    std::array<unsigned int, 3> GLParaArr[4]{};
    QSize componentSizeArr[4]{};
    uint8_t *dataArr[4]{};
    int linesizeArr[4]{}; // 每行实际存储的像素数 = [有效 + 填充]
    int alignment = 1;    // 内存中每个像素行起始处的对齐要求(1,2,4,8)

    // 更新每一帧的像素数据(sws_scale转换)
    void updateFrameData();
    void reset();
    void updateGLParaArr(VideoRenderData::PixFormat fmt);


    VideoRenderData() { reset(); }
    ~VideoRenderData() {
        if (!frmItem.frm) {
            av_frame_free(&frmItem.frm);
        }
    }
};
- 图像格式
enum PixFormat {
        // 可直接上传opengl,通过GLPara获取参数
        NONE = -1,
        RGB_PACKED,
        RGBA_PACKED,

        // 以下类型每个分量独占一个平面
        RGB_PLANAR,
        RGBA_PLANAR,
        Y,
        YA,
        YUV,
        YUVA,
    };
分别有RGB_PACKED RGBA_PACKED 等格式
- 预留
OpneGL接口:
  std::array<unsigned int, 3> GLParaArr[4]{};
    QSize componentSizeArr[4]{};
    uint8_t *dataArr[4]{};
    int linesizeArr[4]{}; // 每行实际存储的像素数 = [有效 + 填充]
    int alignment = 1;    // 内存中每个像素行起始处的对齐要求(1,2,4,8)
分别是OpenGL部分所涉及到的linesize、对齐要求、帧内容。
- 反推
    /**
     * @brief 由像素格式描述推导渲染数据的格式分类
     * @param desc 像素格式描述
     * @return 平面型像素格式分类
     * @note 该函数用于辅助updateFrm函数,使用时确保排除了RGB_PACKED,RGBA_PACKED,每个平面都是独立的
     */
    VideoRenderData::PixFormat desc2PixFormat(const AVPixFmtDescriptor *desc) {
        if (desc->flags & AV_PIX_FMT_FLAG_RGB) {
            return (desc->flags & AV_PIX_FMT_FLAG_ALPHA) ? VideoRenderData::RGBA_PLANAR : VideoRenderData::RGB_PLANAR;
        }

        if (desc->flags & AV_PIX_FMT_FLAG_ALPHA) {
            return desc->nb_components == 2 ? VideoRenderData::YA : VideoRenderData::YUVA;
        }

        return desc->nb_components == 1 ? VideoRenderData::Y : VideoRenderData::YUV;
    }
从AVPixFmtDescriptor 描述符来推测是什么像素格式,然后转换成我们前面的VideoRenderData枚举。
后面方便折合成文本说明符:
    /**
     * @brief 把色彩空间枚举转成可读文本
     * @param colorSpace AVColorSpace 取值
     * @return 名称字符串,未收录的取值返回 "Unknown"
     * @note 当前调用点在 updateFormat() 中被注释掉,保留备用
     */
    const char* colorSpaceToString(int colorSpace) {
        switch(colorSpace) {
            case AVCOL_SPC_RGB: return "RGB";
            case AVCOL_SPC_BT709: return "BT.709";
            case AVCOL_SPC_UNSPECIFIED: return "Unspecified";
            case AVCOL_SPC_BT470BG: return "BT.470BG";
            case AVCOL_SPC_SMPTE170M: return "SMPTE 170M";
            case AVCOL_SPC_SMPTE240M: return "SMPTE 240M";
            case AVCOL_SPC_YCGCO: return "YCGCO";
            case AVCOL_SPC_BT2020_NCL: return "BT.2020 NCL";
            case AVCOL_SPC_BT2020_CL: return "BT.2020 CL";
            case AVCOL_SPC_SMPTE2085: return "SMPTE 2085";
            case AVCOL_SPC_CHROMA_DERIVED_NCL: return "Chroma Derived NCL";
            case AVCOL_SPC_CHROMA_DERIVED_CL: return "Chroma Derived CL";
            case AVCOL_SPC_ICTCP: return "ICTCP";
            default: return "Unknown";
        }
    }
真正把一帧交给 OpenGL 的入口是 updateFormat(),它按像素格式分几种情况处理。
最好办的是打包格式。命中 GLParaMap(RGB24、BGRA 这些)就直接引用 frm->data[0],纹理参数、分量尺寸、行宽、对齐一次填完,上传时一张纹理搞定:
    if (GLParaMap.find(avFmt) != GLParaMap.end()) {
        pixFormat = (flags & AV_PIX_FMT_FLAG_ALPHA) ? PixFormat::RGBA_PACKED : PixFormat::RGB_PACKED;
        GLParaArr[0] = GLParaMap[avFmt];
        componentSizeArr[0] = {frm->width, frm->height};
        dataArr[0] = frm->data[0];
        int bytes_per_pixel = (av_get_padded_bits_per_pixel(desc) / 8);
        linesizeArr[0] = frm->linesize[0] / bytes_per_pixel;
        alignment = getAlignment(dataArr[0], linesizeArr[0] * bytes_per_pixel, frm->linesize[0]);
        return;
    }
碰上大端、Bayer、位流、调色板、XYZ 这类特殊布局,只能把每个分量拆到独立平面:
    if (flags & AV_PIX_FMT_FLAG_BE || flags & AV_PIX_FMT_FLAG_BAYER ||
        flags & AV_PIX_FMT_FLAG_BITSTREAM || flags & AV_PIX_FMT_FLAG_PAL ||
        flags & AV_PIX_FMT_FLAG_XYZ) {
        splitFrameComponentsToPlanes(desc);
        updateGLParaArr(pixFormat);
        return;
    }
分量位深不是 8 或 16 的(10bit 就是这一类)也一样,拆完平面再统一左移到 16 位,纹理按 GL_R16 走:
            for (int j = 0; j < desc->nb_components; ++j) {
                for (auto &x : dst16[j])
                    x <<= (16 - desc->comp[j].depth); // 从[0,2^bits-1)映射到[0,2^16-1),精度比纯数学方法稍差
            }
剩下的是常规平面格式。独占平面的分量直接引用 frm->data,混排的单独拆;色度分量还得按 log2_chroma_w/h 重算宽高,它跟亮度不是一个尺寸:
            if (!(desc->flags & AV_PIX_FMT_FLAG_RGB) && (i == 1 || i == 2)) {
                componentSizeArr[i] = {AV_CEIL_RSHIFT(frm->width, desc->log2_chroma_w), AV_CEIL_RSHIFT(frm->height, desc->log2_chroma_h)};
            }
拆平面用的还是 FFmpeg 自己的读行接口。逐行读是因为行尾可能有填充,不能当连续内存处理:
    for (int y = 0; y < height; ++y) {
        void *line_ptr = (uint8_t *)plane_ptr + y * width * dst_element_size;
        av_read_image_line2(line_ptr, frmData, linesize, desc, 0, y, c, width, read_pal_component, dst_element_size);
    }
帧类型和运动向量也在这个函数里顺手解析:AV_FRAME_DATA_MOTION_VECTORS 侧数据转成项目自己的 MotionVector,frm->pict_type 记成 0/1/2(I/P/B),给运动向量可视化和热力图用。
到这里 RenderData 的准备工作就交代完了。格式、分量尺寸、行宽、对齐这四样整理好,后面上传纹理照抄参数就行。
VideoPlayer
函数签名:bool VideoPlayer::write(AVFrmItem &videoFrmitem)
VideoPlayer 消费的是视频帧队列。每取一帧,它要干三件事:把帧交给 RenderData 整理、算这一帧该等多久、决定发布还是丢掉。
先看数据准备:
    m_videoRenderData.write([&](VideoRenderData &renData, [[maybe_unused]] int idx) -> bool {
        m_lastVideoFrameInterval = nowVideoFrameInterval;
        renData.updateFormat(videoFrmitem);
        return true;
    }, false);
第二个参数 autoRelease 传的是 false,也就是只写数据、先别发布,发布留给醒过来之后那次判断:
    AVFrmItem tmpItem;
    bool peekOk = m_frmBuf->peekFirst(tmpItem);

    nowTime = getRelativeSeconds();
    if (!peekOk || nowTime <= m_renderTime + getDuration(nowVideoFrameInterval, qMakePair(tmpItem.pts, tmpItem.duration))) {
        m_videoRenderData.release();
        m_subRenderData.release();
        emit renderDataReady(&m_videoRenderData, &m_subRenderData);
    } else {
        PlaybackStats::instance().droppedFrameCount++;
    }
睡醒先 peek 一眼队列里的下一帧。按时间轴推算,这帧如果早就该过去了,就直接丢掉、不发布。读端拿到的还是上一帧的完整数据,不会看到画了一半的东西。
节流看的是主时钟:
    double diff = GlobalClock::instance().videoPts() - GlobalClock::instance().getMainPts();
    double syncThreshold = std::max(0.004, std::min(0.01, delay));
    if (!std::isnan(diff) && std::abs(diff) < maxFrameDuration) {
        if (diff <= -syncThreshold) { // 落后太多,尝试直接播放
            PlaybackStats::instance().lateFrameCount++;
            delay = std::max(0.0, delay + diff);
        } else if (diff >= syncThreshold) { // 领先太多
            PlaybackStats::instance().earlyFrameCount++;
            delay = delay + (delay > 0.1 ? diff : delay);
        }
    }
阈值不是定死的,取 max(0.004, min(0.01, delay)):帧间隔越小,允许的偏差也越小。反过来,|diff| 一旦越过 maxFrameDuration,干脆就不纠了,能偏出这个量级的只可能是 seek 或者时间戳跳变,这时候追还不如不追。还有一点,它改的不是时钟,是这一帧还要等多久。
等多久由 m_renderTime 说了算。它是根自己走的时间轴,每帧按 delay 累加,不用额外开定时器。倍速播放时 sleep 除以 speed,单次不超过 0.1 秒;被截断就保持 m_renderTime 不动,下一轮接着追,免得暂停和 seek 被一次长睡拖住。
双缓冲与发布
整理好的数据不是直接交给 GUI 线程,中间隔着一对 AtomicDoubleBuffer:
using VideoDoubleBuf = AtomicDoubleBuffer<VideoRenderData>;
using SubtitleDoubleBuf = AtomicDoubleBuffer<SubRenderData>;
它只用一个 uint8_t,位分配是这样的:
    /**
     * 原子状态位:
     * bit 0: latest_idx (0 或 1) -> 标记哪一个是最新写完的
     * bit 1: buf0_busy  (1 为忙) -> 读线程正在读 buffers[0]
     * bit 2: buf1_busy  (1 为忙) -> 读线程正在读 buffers[1]
     * bit 3: empty      (0 为空) -> 两个buffers都没准备好
     */
写线程只碰非 latest 那一份,要是读端正锁着它,就让出 CPU 等一会:
    // 如果读线程正锁着要写的那个,则“等一会”
    while (m_state.load(std::memory_order_acquire) & targetBusyBit) {
        std::this_thread::yield();
    }
读线程反过来,用 CAS 去抢 latest 那份的 Busy 位。两边各管一半,谁也不会踩到谁。
写进 buffer 不等于发布。VideoPlayer 把 write() 的第二个参数传成了 false,只写不发布;真正的发布是 release(),它同时更新 latest 索引位和就绪位。读端读完会清 Busy 位,如果这期间 latest 没被改过,还会顺手把就绪位也清掉。所以暂停时 read() 返回 false,paintGL 不更新纹理,屏幕上就停着最后一帧。
把"写"和"发布"拆成两步,丢帧就省事多了:发现这帧过时了,不调用 release() 就行。数据已经写进 buffer,但读端看不到,还是显示上一帧。
VideoWidget
VideoWidget 继承 QOpenGLWidget,GL 上下文在 GUI 线程,所以从槽函数到绘制全程串行,不用加锁。
它拿到的是一条信号带上来的两个裸指针(VideoDoubleBuf* 和 SubtitleDoubleBuf*),槽里几乎什么都不做:
void VideoWidget::updateRenderData(VideoDoubleBuf *vidData, SubtitleDoubleBuf *subData) {
    m_vidData = vidData;
    m_subData = subData;
    update();
}
真正的活在 paintGL() 里。它先 read() 锁住最新一份数据,再按分量上传纹理:
    auto uploadTexture = [&](int pos, GLenum textureOffset) {
        glActiveTexture(GL_TEXTURE0 + textureOffset);
        glBindTexture(GL_TEXTURE_2D, m_texArr[textureOffset]);
        glPixelStorei(GL_UNPACK_ALIGNMENT, alignment);
        glPixelStorei(GL_UNPACK_ROW_LENGTH, linesizeArr[pos]); // 一行存储的像素个数 [用于显示的像素个数] + [用于填充的像素个数(这部分需要丢弃)]
        glTexSubImage2D(GL_TEXTURE_2D, 0, 0, 0,
                        componentSizeArr[pos].width(), componentSizeArr[pos].height(),
                        GLParaArr[pos][1], GLParaArr[pos][2],
                        dataArr[pos]);
    };
这两个 glPixelStorei 算是渲染里最阴暗的地方:FFmpeg 的 linesize 通常大于有效宽度,多出来的是行尾对齐填充,不能当连续内存读,所以要告诉驱动每行的有效像素个数,让它自己跳过;对齐值则是从数据首地址和 linesize 反推出来的 1/2/4/8。
纹理单元也是定好的:0 到 3 号放视频的四个分量(Y/U/V/A 或 R/G/B/A),4 号固定给字幕。字幕上传前会先把上一次的矩形区域刷成透明再贴新的,不然新字幕比旧的窄,边缘就会留下残影。
传完纹理就画:清一层深灰底,绑纹理,写入变换矩阵以及亮度、对比度、饱和度、颜色空间几个 uniform,然后画个全屏四边形。变换矩阵那段代码的顺序和生效顺序是反的,读起来是"先按视频比例摆正 → 旋转 → 缩放与镜像 → 适配窗口宽高比 → 位移"。
AVFrmItem
这个部分则是对音视频容器的包装,它的实现是这样的,顺便也看一下AVPktItem的实现
struct AVPktItem {
    AVPacket *pkt = nullptr;
    int serial = 0;
};

struct AVFrmItem {
    AVFrame *frm = nullptr;
    AVSubtitle sub{};
    int width{0}, height{0}; // 目前仅用于表示字幕的分辨率大小
    int serial = 0;
    double pts = INVALID_DOUBLE;
    double duration = INVALID_DOUBLE;
};
其中INVALID_DOUBLE为 constexpr double INVALID_DOUBLE = std::numeric_limits<double>::quiet_NaN();
自然地产生了一个问题,为什么要用quite_NAN来实现呢:这是因为:NaN 是 IEEE 754 里唯一不属于实数域的值,它跟任何合法 pts 都不相等,这是它能当哨兵的根本原因
serial序列号:它标志着正在播放的源是那一个,换源的时候序列号会自增addSerial()。AVFrame为解码后的内容,它承载了画面的数据。
五、时钟
目录大概是这样的:
clock/ GlobalClock + Clock // 三时钟(音频/视频/外部)+ 主时钟
Clock 是单个时钟,GlobalClock 是持有三个 Clock 的单例(音频、视频、外部),对外只回答一个问题:现在第几秒。
首先我们针对基础的 Clock 来介入。
Clock
时钟本身不存“当前时间”,它只存一个锚点:
void Clock::setClock(double pts, double time) {
    m_updatePts = pts;
    m_updateTime = time;
}

void Clock::setClock(double pts) {
    setClock(pts, getRelativeSeconds());
}

double Clock::getPts() {
    if (m_paused) {
        return m_updatePts;
    } else {
        return m_updatePts + (getRelativeSeconds() - m_updateTime) * m_speed;
    }
}
m_updatePts 是最近一次被写入的媒体时间戳,m_updateTime 是那一刻的现实时间。之后每次询问,就用现实流逝的秒数乘以速度补上去。也就是说,两次写入之间时钟自己也在走,不需要每帧喂值。
现实时间取的是 std::chrono::steady_clock:它单调,不受用户改系统时间影响,拿它推算时间轴才不会跳。
double getRelativeSeconds() {
    auto nowTime = std::chrono::steady_clock::now();
    // Target 时间点约莫是系统启动时间点
    return std::chrono::duration<double>(nowTime.time_since_epoch()).count();
}
暂停和调速都要先把当前 pts 固化下来,再改状态:
void Clock::setSpeed(double newSpeed) {
    setClock(getPts()); // 保证从时钟更新起点 到 当前时间点都是以这个速度运行的
    m_speed = newSpeed;
}

void Clock::togglePaused() {
    setClock(getPts());
    m_paused = !m_paused;
}
如果不固化,调速之后用新速度去乘“从旧锚点开始的全部现实时间”,就会凭空多算或者漏算一段。
上面这些合起来就是单个时钟的计算规律:
展开图表
GlobalClock
单例里并排放着三个 Clock,外加一个“谁说了算”的标记:
GlobalClock::GlobalClock()
    : m_mainClockType(ClockType::AUDIO),
      m_audioClk(ClockType::AUDIO), m_videoClk(ClockType::VIDEO),
      m_externalClk(ClockType::EXTERNAL), m_maxFrameDuration(10.0) {
}
取“现在第几秒”只认主时钟:
double GlobalClock::getMainPts() {
    switch (m_mainClockType) {
    case ClockType::AUDIO:
        return m_audioClk.getPts();
    case ClockType::VIDEO:
        return m_videoClk.getPts();
    case ClockType::EXTERNAL:
        return m_externalClk.getPts();
    default:
        return INVALID_DOUBLE;
    }
}
主时钟类型在 MediaController::open() 里按流的可用情况定:有音频流就用 AUDIO,只有视频流才降到 VIDEO,两个都没有直接关流:
        GlobalClock::instance().reset();
        // 有音频时主时钟为Audio,否则为Video
        GlobalClock::instance().setMainClockType(haveAudio ? ClockType::AUDIO : ClockType::VIDEO);
进度条、渲染节拍、Demux 切流后的再定位,读的都是 getMainPts(),所以整个工程的“当前播放位置”只有一个答案。
外部时钟比较特殊,它不参与主时钟选举,只单向跟随,而且跟随有个门限:
void Clock::syncToClock(Clock &clk) {
    double nowPts = getPts();
    double newPts = clk.getPts();
    if (!std::isnan(newPts) && (std::isnan(nowPts) || std::abs(newPts - nowPts) > 10.0)) {
        setClock(newPts);
    }
}
差异超过 10 秒才跟随:小偏差不管,明显脱节(多数是 seek 之后)才拉一次。
reset() 则把三个时钟的 pts 全部置成 NaN、速度归 1.0、暂停位清零:
void GlobalClock::reset() {
    m_videoClk.setClock(INVALID_DOUBLE);
    m_audioClk.setClock(INVALID_DOUBLE);
    m_externalClk.setClock(INVALID_DOUBLE);
    m_videoClk.m_speed = m_audioClk.m_speed = m_externalClk.m_speed = 1.0;
    m_videoClk.m_paused = m_audioClk.m_paused = m_externalClk.m_paused = false;
}
所以“时钟有没有效”这件事全靠 std::isnan 判断,播放器里那些 NaN 检查,等的就是第一次真实 pts 落进来。
三个时钟、主时钟与读写关系合起来是这样:
展开图表
谁来写时钟
往里写时钟的有三处。
音频播放器在 miniaudio 的数据回调里回写。它算得出缓冲里还有多少秒没播,“已写入的总时长减去未播时长”就是当前位置:
    double offsetPts = buffer->readAvailable() / bytesPerSec; // 未播的时间
    GlobalClock::instance().setAudioClk(nextPtr - offsetPts);
这个数字不是估出来的,是按硬件实际消费掉的字节数换算的,精度取决于 PCM 缓冲的水位(所以那个缓冲设成 100ms)。
视频播放器每写一帧更新一次视频时钟,顺带让外部时钟跟一下:
    // 更新视频时钟
    GlobalClock::instance().setVideoClk(videoFrmitem.pts);
    GlobalClock::instance().syncExternalClk(ClockType::VIDEO);
视频时钟因此是一跳一跳往前推进的,永远等于“最近一帧的 pts 加现实外推”。
Demux 在 seek 完成、读到第一个包时,按这个包的 pts 把音视频时钟一起拨过去:
            double seekedPts = pkt->pts * av_q2d(m_formatCtx->streams[pkt->stream_index]->time_base);
            // 提前设置一下时钟,能比较好的避免出现视频pts先更新且落后与音频,导致视频疯狂更新,然后音频再更新,导致视频领先与音频,最后导致视频变卡一会儿
            GlobalClock::instance().setAudioClk(seekedPts);
            GlobalClock::instance().setVideoClk(seekedPts);
            emit seeked(seekedPts);
不一起拨会出事:中间会出现“一方已到新位置、另一方还在旧位置”的窗口,视频侧就会疯狂重复或者丢帧。注释里那句写的就是这个。
谁来读时钟
读取主要在两处。
视频侧读它算这一帧该不该等:
    double diff = GlobalClock::instance().videoPts() - GlobalClock::instance().getMainPts();
    double syncThreshold = std::max(0.004, std::min(0.01, delay));
主时钟是音频时,音频自己不做纠偏(它就是基准),同步成本全压在视频这边:偏差在阈值内就微调这一帧的等待时长,超了整帧丢弃。
进度条读它当播放位置:
int MediaController::getCurrentTime() const {
    double ptsSecond = GlobalClock::instance().getMainPts();
    int res = std::isnan(ptsSecond) ? 0 : static_cast<int>(ptsSecond);
    // 确保时间在0到duration范围内
    return std::max(0, std::min(res, m_duration));
}
Demux::switchStream() 切流后再定位也是读它;MediaController::getSyncDifference() 则拿 videoPts() 减 audioPts(),给界面显示同步差。
最后提一下 maxFrameDuration:这个值住在时钟里,却由 Demux 在 init 时按容器特性设定(AVFMT_TS_DISCONT 为 10 秒,否则 3600 秒),视频侧拿它当“偏差大到什么程度就不该纠偏”的上限。
六、流媒体
协议识别与打开
函数签名:bool StreamManager::open(const QUrl& url)
先按 URL 归类,只认四种:
StreamProtocol StreamManager::detectProtocol(const QUrl& url) {
    QString scheme = url.scheme().toLower();
    QString path = url.path().toLower();

    if (scheme == "rtmp" || scheme == "rtmps" || scheme == "rtmpte" || scheme == "rtmpt") {
        return StreamProtocol::RTMP;
    } else if (scheme == "rtsp" || scheme == "rtsps") {
        return StreamProtocol::RTSP;
    } else if (path.endsWith(".m3u8") || scheme == "http" || scheme == "https") {
        // HLS 通常是 m3u8,也可能是 http/https 直播流
        return StreamProtocol::HLS;
    } else if (url.isLocalFile() || scheme.isEmpty()) {
        return StreamProtocol::LocalFile;
    }
    return StreamProtocol::Unknown;
}
open() 本身很轻,只把状态推到“连接中”,顺带点起缓冲监控定时器:
bool StreamManager::open(const QUrl& url) {
    m_currentUrl = url;
    m_stats.reset();
    m_stats.url = url.toString();
    m_stats.protocol = detectProtocol(url);
    ...
    setState(StreamState::Connecting);
    m_stats.connectionAttempts++;
    m_backoff->reset();
    m_connectTimer.start();

    // 缓冲监控启动
    m_bufferMonitorTimer->start();

    return true;
}
它并没有真的去建立连接。真正的打开动作在 MediaController 那边由 Demux 完成,成功和失败也是 MediaController 手动调过来的:
        ok &= m_demux->init(openPath.toUtf8().constData(), true);
        if (!ok) {
            ...
            m_streamManager->onDemuxError("Failed to initialize demux for: " + openPath);
            close();
            return false;
        }

        m_streamManager->onDemuxConnected();
所以 StreamManager 更像是状态和策略的看护者:本地文件和网络流走同一套状态机,区别只在出错之后怎么处理。
状态机与信号
所有状态切换都收在一个入口,状态没变就直接返回:
void StreamManager::setState(StreamState state) {
    if (m_stats.state == state) return;

    StreamState oldState = m_stats.state;
    m_stats.state = state;
    ...
    emit stateChanged(oldState, state);

    // 处理状态变化的特殊逻辑
    if (state == StreamState::Buffering) {
        emit bufferingStarted();
    } else if (oldState == StreamState::Buffering &&
               (state == StreamState::Playing || state == StreamState::Paused)) {
        emit bufferingEnded();
    }

    if (state == StreamState::Connected) {
        emit connected();
    } else if (state == StreamState::Error) {
        emit error(m_stats.lastErrorMsg);
    }
}
集中分发的好处是 UI 只接少数几个信号,不用自己判断迁移。MediaController 把其中四个直接转成了自己的信号:streamStateChanged、bufferProgress、streamError、reconnecting。
连接成功后要先把退避计数清零,再决定要不要先进缓冲:
void StreamManager::onDemuxConnected() {
    m_backoff->onSuccess();
    setState(StreamState::Connected);

    // 检查是否需要缓冲
    if (m_config.preBufferSizeMB > 0) {
        setState(StreamState::Buffering);
    } else {
        emit readyToPlay();
    }

    updateStatsFromDemux();
}
退避重连
重连是指数退避加次数上限的组合:
void StreamManager::startReconnect() {
    if (m_backoff->hasReachedMaxRetries()) {
        m_stats.lastErrorMsg = "Maximum retry attempts reached";
        setState(StreamState::Error);
        emit connectionFailed(m_stats.lastErrorMsg);
        return;
    }

    setState(StreamState::Reconnecting);
    emit reconnecting(m_backoff->getRetryCount() + 1, m_config.maxRetryCount);

    m_backoff->onFailure();
    m_backoff->scheduleNextRetry([this]() {
        performReconnect();
    });
}
次数到顶就进 Error 并发 connectionFailed;否则进 Reconnecting,把"第几次 / 共几次"发给 UI 显示,再由 ExponentialBackoff 排下一次尝试。
performReconnect() 目前只把状态切回 Connecting 并累加计数,真正的重连调用还留空着:
void StreamManager::performReconnect() {
    if (m_isShuttingDown) return;
    ...
    setState(StreamState::Connecting);
    m_stats.connectionAttempts++;

    // 实际重连逻辑应该触发Demux重新连接
    if (m_demux) {
        // 这里可以添加实际重连调用
    }
}
错误与 EOF 的入口按协议分流:本地文件直接进 Error,网络流则尝试重连:
void StreamManager::onDemuxError(const QString& error) {
    ...
    if (m_stats.protocol == StreamProtocol::LocalFile) {
        setState(StreamState::Error);
    } else {
        // 网络流错误,尝试重连
        startReconnect();
    }
}
onDemuxEOF() 同理,只有非本地文件才当作断线处理。对网络流来说,读到末尾通常就是链路没了。
缓冲水位
水位是估算出来的,不是数出来的。有码率就按 0.5 秒的数据量折算:
double StreamManager::calculateEstimatedBufferMB() {
    ...
    if (m_stats.bitrateKbps > 0) {
        // 按 bitrate 估算,假设缓冲了 0.5秒的数据
        double bits = m_stats.bitrateKbps * 500.0;
        estimatedMB = bits / (8.0 * 1024.0 * 1024.0);
    } else {
        // 默认预估值
        estimatedMB = m_config.preBufferSizeMB;
    }

    return estimatedMB;
}
定时器周期性地调 updateBufferStatus(),把够不够缓冲翻译成状态迁移:
    // 检查是否需要缓冲
    bool needsBuffer = !hasEnoughBuffer();
    if (needsBuffer && !m_stats.isBuffering && m_stats.state == StreamState::Playing) {
        m_stats.isBuffering = true;
        setState(StreamState::Buffering);
    } else if (!needsBuffer && m_stats.isBuffering) {
        m_stats.isBuffering = false;
        if (m_stats.state == StreamState::Buffering) {
            setState(StreamState::Playing);
        }
    }
水位有变化就发 bufferProgressChanged(percent, MB),界面上的缓冲进度就是这条信号驱动的。
去抖与配置
播放、暂停、seek 这些操作不直接落地,都要过一遍去抖(默认 300ms):
void StreamManager::seek(double positionSec) {
    m_debounce->debounce("seek", [this, positionSec]() {
        qDebug() << "Seek to:" << positionSec << "s";
        if (m_demux) {
            m_demux->seekBySec(positionSec, 0.0);
        }
    });
}
play 与 pause 共用同一个 key(play_pause),所以快速连点只执行最后一次;seek 用独立的 key,不会和播放控制互相顶掉。
参数都集中写在 StreamingConfig 里:
struct StreamingConfig {
    // 指数退避参数
    double initialIntervalMs = 1000.0;        // 初始重试间隔(ms)
    double backoffFactor = 2.0;              // 退避因子
    double maxIntervalMs = 30000.0;          // 最大重试间隔(ms)
    int maxRetryCount = 5;                  // 最大重试次数

    // 缓冲配置 (MB)
    double preBufferSizeMB = 2.0;           // 预缓冲大小
    double minBufferThresholdMB = 0.5;      // 最小缓冲阈值

    // 播放控制防抖(ms)
    int debounceTimeMs = 300;               // 防抖间隔

    // 目标延迟(秒) - 尽量控制
    double maxLatencySec = 3.0;
};
重连最慢 30 秒一次、最多 5 次;水位低于 0.5MB 就认为缓冲不够;预缓冲按 2MB 归一算进度。
