零解码与渲染(二):高效率的零解码工厂
接到上节,FFmpeg成功地从网络流与RTMP握手建立连接。
下面是本文中比较关键的一些信息:
AVPacket的内存布局
typedef struct AVPacket {
    AVBufferRef *buf;        // ← 源音视频数据块,引用计数在这里
    int64_t pts, dts;
    uint8_t *data;           // = buf->data + offset,通常等于 buf->data
    int      size;
    int      stream_index;
    int      flags;          // AV_PKT_FLAG_KEY 表示关键帧
    AVPacketSideData *side_data;
    ...
} AVPacket;
FFmpeg的临时缓冲区
/* libavformat/avio_internal.h */
#define IO_BUFFER_SIZE 32768

/* libavformat/avio.c —— ffio_open_whitelist() 简化 */
int buffer_size = IO_BUFFER_SIZE;                  // 默认 32768
av_opt_get_int(opts, "buffer_size", AV_OPT_SEARCH_CHILDREN, &buffer_size);  // 被选项覆盖
buffer = av_malloc(buffer_size);                   // ← 用户态堆内存,FFmpeg 自己 malloc
ffio_init_context(s, buffer, buffer_size, 0, h, ffurl_read, ffurl_write, ffurl_seek);
追本溯源
展开图表
Mermaid由蓝色大肥鱼提供
我们可以追溯到FFmpeg和Linux网络栈的最终交互点:sk_receive_queue
sk_receive_queue 是 Linux 内核中用于管理接收数据包的队列。它在网络协议栈中扮演着重要角色。
至此向下为:RTMPPacket.data 从Linux网络协议栈内核终点作为临时抓手获得的数据,RTMPPacket有“阅后即焚”这一角色。
模糊不清的分发状态
为了解决这点,我们要根据RTMP协议栈来明确分析RTMP Chunk是如何交付的。
当RTMP到来时:处于这样一个情况
[#1 128B][#2 128B][#3 128B] ... [#31 128B][#32 32B]
分成了很多的块。每包最多 128 字节,最后一块 32 字节
继续拆分成这样
[#1 头12B+128B] [#2 头1B+128B] [#3 头1B+128B] ... [#32 头1B+32B]
把一路 RTMP 和一个 200 字节的音频帧一起放上分析,链路上是一条字节队列:
链路上的字节(时间从左到右)
┌─────┬─────┬─────┬─────┬─────┬─────┬─────┬─────┬─────┐
│ V#1 │ A#1 │ V#2 │ A#2 │ V#3 │ V#4 │ V#5 │ V#6 │ ... │
└─────┴─────┴─────┴─────┴─────┴─────┴─────┴─────┴─────┘
  ↑视频  ↑音频  ↑音频
  音视频交错排列。第二块就是最后一块(72B),音频到此结束
但是以TCP协议栈的角度,并不是这样
tcpdump / recv() 看到的不是这一个个块,而是 TCP 段。一个 MSS=1460 的段能装约 10 个 chunk:
包 #1(1460 字节)
+--------------------------------------+
| V#1 full(140B) | A#1 full(140B)      |
| V#2 | A#2 | V#3 | V#4 | V#5          |
| V#6 | V#7 | V#8 | V#9 first half     |
+--------------------------------------+
注意看,这个包被切成了半截,这下包 #1 可惨了


包 #2(1460 字节)
┌───────────────────────────────────────────────────────────────┐
│ V#9后半截 │ V#10 │ V#11 │ ...                                  │
└───────────────────────────────────────────────────────────────┘
留着包 #1的后半截。
因此出现了一个比较严重的问题,就是半包
所以我们要进行固定的切,按规格来定
一帧视频 4000B ──按 128B 切──▶ 32 个块 (csid=6)
一帧音频  200B ──按 128B 切──▶  2 个块 (csid=4)
半包
FFmpeg给出的方案是:
static inline int retry_transfer_wrapper(URLContext *h, uint8_t *buf, const uint8_t *cbuf,
                                        int size, int size_min, int read)
{
    int len = 0;
    while (len < size_min) {
        ...
        ret = read ? h->prot->url_read(h, buf + len, size - len) : ...;
        ...
        len += ret;
    }
    return len;
}
-
块没读完,怎么办?
size:我总共要多少字节size_min:至少要凑到多少字节才算成功len:目前已经拿到多少字节buf:数据往哪儿放的起点
while (len < size_min) 表示我还没有读够
url_read(h, buf + len, size - len) 说明我要
buf + len   →  这次从哪里开始写
size - len  →  这次最多读几字节
| 轮次 | 进来时 len | buf + len |
size - len |
实际读到 | 出去时 len |
|---|---|---|---|---|---|
| One | 0 | buf+0(从头写) | 3 | 1 字节 | 1 |
| Two | 1 | buf+1(接在后面写) | 2 | 2 字节 | 3 |
| Three | 3 | — | — | 循环条件 3 < 3 不成立,退出 |
返回 3 |
说明FFmpeg的处理方式并不给调用者拿到半包的机会,都是等待全包到了才能用。
那么等待的过程中会卡死吗,接下来给出方案。
        if (ret == AVERROR(EAGAIN)) {
            ... av_usleep(1000);
            if (h->rw_timeout && av_gettime_relative() > wait_since + h->rw_timeout)
                return AVERROR(EIO);
        } else if (ret == AVERROR_EOF)
            return (len > 0) ? len : AVERROR_EOF;
| 返回值 | 含义 | 代码怎么做 |
|---|---|---|
EAGAIN |
现在暂时没数据(非阻塞 fd) | 睡 1ms 再试;超过 rw_timeout 就报错 EIO 放弃 |
EINTR |
被系统信号打断 | continue,重新读 |
EOF |
对端已关闭,永远不会有新数据了 | 返回已读到的部分(len > 0),因为再等也没意义 |
也就是说:正常情况下永远返回完整数据,只有对端断线才可能返回半截。
av_usleep(1000) 那 1 毫秒是为了CPU,如果一直 while 会导致空转。
int ffurl_read_complete(URLContext *h, unsigned char *buf, int size)
{
    return retry_transfer_wrapper(h, buf, NULL, size, size, 1);
}                                                    // ↑ size_min = size

int ffurl_read(URLContext *h, unsigned char *buf, int size)
{
    return retry_transfer_wrapper(h, buf, NULL, size, 1, 1);
}                                                    // ↑ size_min = 1
size_min 的两个取值,决定两种行为
- 读满 size 字节才返回,对应是 RTMP 解析头部、读 payload
- 至少有 1 字节就返回,可能只有 10 字节。(AVIO 缓冲补货可能)
解复用
音视频Packet
struct AVPacketItem {
    AVPacket *pkt    = nullptr;
    uint64_t  serial = 0;

    AVPacketItem() = default;
    AVPacketItem(AVPacket *p, uint64_t s) : pkt(p), serial(s) {}

    // unref 内部 buf + 释放 AVPacket 结构体,并把 pkt 置空
    ~AVPacketItem() { av_packet_free(&pkt); }

    AVPacketItem(AVPacketItem &&o) noexcept : pkt(o.pkt), serial(o.serial) { o.pkt = nullptr; }

    AVPacketItem &operator=(AVPacketItem &&o) noexcept {
        if (this != &o) {
            av_packet_free(&pkt);   // 覆盖旧值前先释放
            pkt    = o.pkt;
            serial = o.serial;
            o.pkt  = nullptr;
        }
        return *this;
    }

    AVPacketItem(const AVPacketItem &)            = delete;
    AVPacketItem &operator=(const AVPacketItem &) = delete;
};
AVPacket *pkt = nullptr;这是原始视频数据的指针。uint64_t serial = 0;序列号,用来标记是第几次播放,切换视频的时候会改变。AVPacketItem& operator=(AVPacketItem&& o) noexcept 运算符 =重载,逐步给予内容和权限,先释放旧值再接受新值。
解复用原理
typedef struct AVPacket {
    AVBufferRef *buf;      // 真正的数据持有者(引用计数),av_packet_ref 只加计数不拷贝
    int64_t      pts;      // 显示时间戳,单位由 time_base 决定(流级别通常是 1/90000 或 1/1000)
    int64_t      dts;      // 解码时间戳
    uint8_t     *data;     // 压缩数据起始指针 = buf->data + offset
    int          size;     // data 的字节数(不含末尾 64B padding)
    int          stream_index; // 属于第几条流(对应 AVStream.index)
    int          flags;    // AV_PKT_FLAG_KEY / CORRUPT / DISCARD / TRUSTED
    AVPacketSideData *side_data;  // 旁路数据,如 HDR 元数据、参数集
    int          side_data_elems;
    int64_t      duration; // 以流 time_base 为单位(RTMP 常为 0,因为容器不提供)
    int64_t      pos;      // 字节偏移,网络流通常是 -1
    void        *opaque;   // 应用私有
    AVBufferRef *opaque_ref;
    AVRational   time_base; // FFmpeg 6.1+ 特性,包自带时基
} AVPacket;
这是FFmpeg的AVPacket的构成,包含了一个AVPacket块里各种基础的元信息。
下面是解复用部分的关键骨架:
#include <libavformat/avformat.h>

int demux_loop(const char *url, PacketBuffer *buf)
{
    AVFormatContext *fmt = NULL;
    int ret = 0, vst;

    /* 1. 打开:URL → 选协议 → 建 AVIOContext → 探测容器 → read_header */
    if ((ret = avformat_open_input(&fmt, url, NULL, NULL)) < 0)
        goto fail;

    /* 2. 预读若干包,把 codecpar(extradata/宽高/采样率)填完整 */
    if ((ret = avformat_find_stream_info(fmt, NULL)) < 0)
        goto fail;

    /* 3. 选流:视频优先,没有就音频 */
    vst = av_find_best_stream(fmt, AVMEDIA_TYPE_VIDEO, -1, -1, NULL, 0);
    if (vst < 0)
        vst = av_find_best_stream(fmt, AVMEDIA_TYPE_AUDIO, -1, -1, NULL, 0);

    /* 4. 取包循环 —— 解复用的全部业务逻辑*/
    while ((ret = av_read_frame(fmt, pkt)) >= 0) {
        if (pkt->stream_index == vst) {
            AVPacket *p = av_packet_alloc();
            av_packet_move_ref(p, pkt);          /* 零拷贝转移 buf 所有权 */
            buf_push(buf, p, serial);            /* → pktBuf */
        }
        av_packet_unref(pkt);                    /* 不 unref 会内存泄漏的 */
    }
fail:
    av_packet_free(&pkt);
    avformat_close_input(&fmt);                  /* 内部 free pb、streams、priv_data */
    return ret == AVERROR_EOF ? 0 : ret;
}
AVFormatContext:包含了音视频格式的上下文信息。AVPacket *pkt = av_packet_alloc();内存中创建可复用的一个临时AVPacket小缓冲区。
真正核心部分是这个循环取包投给解复用器的环节,解复用是FFmpeg的函数,我们能做的就是进行调用,但是解复用核心是如何完成的呢?
继续向下追溯
Assume that: 我们Get到 一个 H.264 关键帧,NALU 21 字节,rtmp_read 已经把它包装成 FLV 流的形状:
Offset Bytes                      Meaning
------ -------------------------  --------------------------------------------
0x00   46 4C 56 01 05 00 00 00 09  FLV header "FLV" ver=1 flags=0x05 hdrsize=9
0x09   00 00 00 00                 PreviousTagSize0
------ -------------------------  ---- 以下是 flv_read_packet 要处理的部分 ----
0x0D   09                          TagType      = 9 (video)
0x0E   00 00 1E                    DataSize     = 30
0x11   00 03 E8                    Timestamp    = 1000 (ms)
0x14   00                          TimestampExt = 0
0x15   00 00 00                    StreamID     = 0
------ -------------------------  ---- 以下 30 字节 = tag body ----
0x18   17                          frametype=1(key) | codecid=7(AVC)
0x19   01                          AVCPacketType = 1 (NALU)
0x1A   00 00 00                    CompositionTime = 0
0x1D   00 00 00 15                 NALU 长度 = 21
0x21   65 88 84 00 0F FF F0 33 ..  IDR NALU (nal_ref_idc=3, type=5)
0x35   ..                          (NALU 到 0x35 结束)
------ -------------------------  --------------------------------------------
0x36   00 00 00 1E                 PreviousTagSize = 30
内部从原始数据到AVpacket的流程是这样:
字节来源(socket / 文件)
  │
  ├─[0] URL 解析 → 选 protocol → 建 fd
  ├─[1] 协议层 → 变成"可顺序读的字节流"(RTMP 在这一层解决 chunk 和伪 FLV)
  ├─[2] probe  → 认出这是哪个容器,选定 AVInputFormat
  ├─[3] read_header → 建 AVStream 表,填 codecpar(宽高/编码/采样率)
  ├─[4] read_packet → 剥封装,一个 tag/sample → 一个 AVPacket
  └─[5] av_read_frame → 包装:丢无效包、补 duration、附 side data
  │
AVPacket
假设我们用hexdump来分析AVPacket* pkt->data
偏移    字节              字段语义
------  ----------------  ------------------------------------------------
0x00    00 00 00 15       NALU 长度前缀 = 21(大端)
                           └ AVCC 格式特有,由 demux 保留
0x04    65                NALU header
                             0 11 00101
                             │ │  └─┬─┘
                             │ │    └ nal_unit_type = 5 (IDR slice)
                             │ └────── nal_ref_idc   = 3 (被参考)
                             └──────── forbidden_zero_bit = 0
0x05    88                slice_header 起(比特流从这里开始算)
                             1 0001000
                             │ └─┬───┘
                             │   └ slice_type: ue(v) = 7 (I)
                             └───── first_mb_in_slice: ue(v) = 0
0x06    84                slice_header 续
                             1 0000 1 00
                             │ │    │ └┬┘
                             │ │    │  └ pic_order_cnt_lsb 起始(续到 0x07)
                             │ │    └── idr_pic_id: ue(v) = 0
                             │ └────── frame_num: u(4) = 0
                             └──────── pic_parameter_set_id: ue(v) = 0
0x07    00                pic_order_cnt_lsb 续 → POC = 0
                             000000 00
                             └─┬──┘ └┬┘
                               │     └ 后续字段(本例 POC 按 8 bit 画)
                               └ pic_order_cnt_lsb 续(前 6 bit)
0x08    0F                slice_header 尾部(deblocking 等参数,取决于 SPS/PPS)
0x09    FF F0 33 ...      CABAC 算术编码数据(黑盒,不再可逐位解析)
------  ----------------  ------------------------------------------------------------  --------------------------------------------
-
NALU Header Prefix:NALU长度前缀标识 -
NALU header:NALU头部结构 (针对于H.264 特有) -
slice:-
H.264 中,一帧图像(picture/frame)可以被划分为一个或多个 slice:
一帧图像 (picture / frame)
 ├── slice 0
 │    ├── slice_header
 │    └── slice_data(若干宏块)
 ├── slice 1
 │    ├── slice_header
 │    └── slice_data(若干宏块)
 └── ...
-
所以slice_header(Begin)到slice_header(Next)始终代表slice的头部。
其中装载了
first_mb_in_slice     从第几个宏块开始
slice_type            I / P / B slice
pic_parameter_set_id  用哪个 PPS
frame_num             帧号
pic_order_cnt_lsb     显示顺序 POC
参考帧列表、QP、去块滤波参数等
pic_order_cnt_lsb 是 POC(Picture Order Count,图像顺序计数)的低位部分,用来告诉解码器:这一帧应该按什么顺序显示。POC = Picture Order Count,中文常叫“图像顺序计数”。它是 H.264 里给每帧图像分配的一个显示顺序编号
继续用hexdump来分析pkt->buf
偏移    字节                          归属          说明
------  ----------------------------  ------------  ----------------------------------------------
0x00    17                            被裁掉         frametype=1(key) | codecid=7(AVC)
0x01    01                            被裁掉         AVCPacketType = 1 (NALU)
0x02    00 00 00                      被裁掉         CompositionTime = 0
------  ----------------------------  ------------  以上 5 字节仍在内存里,只是视图跳过
0x05    00 00 00 15                   pkt->data+0   NALU 长度前缀(=21,大端)
0x09    65                            pkt->data+4   NALU header
0x0A    88 84 00 0F FF F0 33 ...      pkt->data+5   slice_header + CABAC(至 0x1D)
0x1E    00 00 ... (64 字节)            padding       解码器 SIMD 越界读保护,强制零
------  ----------------------------  ------------  ----------------------------------------------
0x5E    ─                             结束          buf 总长 0x5E = 94 字节
-
前5个字节是FLV容器层的“Video Tag Header”,告知“这个视频标签里装的是什么、该怎么处理”,所以解复用环节需要把他们跳过。
-
其他就是上面分析过的内容了
Question:为什么要分成data和buf两个层面设计
AVPacket 的 data 和 buf 分离设计,核心是为了实现引用计数式的内存管理,从而在多个 AVPacket 之间高效、安全地共享数据,避免昂贵的拷贝。
也就是说,data指向了内存的实际数据地址。而buf是为了标记谁在用这段数据,有多少地方应用了,有点像shared_ptr的引用计数概念。
对于裸数据流来说,解复用拆掉了这些,保留了那些:
| 层次 | “原始”指什么 | 解复用与它的关系 |
|---|---|---|
| ① 像素层 | 摄像头吐的 YUV | 完全无关,是编码前的事 |
| ② 码流层 | H.264 NALU 序列(Annex-B / AVCC) | 几乎不动 |
| ③ 容器层 | FLV/MP4/TS 的封装字节 | 全部拆掉 |
队列设计
SPSC缓冲区
/**
 * 单生产者单消费者的有限无锁队列(缓冲区)
 */
template <typename T>
class SPSCQueue {
public:
    explicit SPSCQueue(size_t capacity)
        : m_capacity(capacity + 1), // 多分配一个,用于处理满条件
          m_buffer(m_capacity) {}

    bool push(const T &value) {
        // 生产者本地快照
        size_t current_tail = m_tail.load(std::memory_order_relaxed);
        size_t next_tail = nextIndex(current_tail);

        // 检查队列是否已满
        if (next_tail == m_head.load(std::memory_order_acquire)) {
            return false; // 队列满,推送失败
        }

        // 将数据存入当前tail指向的位置
        m_buffer[current_tail] = value;

        // 发布tail的更新,确保前面的数据存储对消费者可见
        m_tail.store(next_tail, std::memory_order_release);
        return true;
    }

    bool pop(T &value) {
        // 消费者本地快照
        size_t current_head = m_head.load(std::memory_order_relaxed);

        // 检查队列是否为空
        if (current_head == m_tail.load(std::memory_order_acquire)) {
            return false; // 队列空,弹出失败
        }

        // 从当前head指向的位置取出数据
        value = m_buffer[current_head];

        // 发布head的更新,告知生产者新的头部位置
        m_head.store(nextIndex(current_head), std::memory_order_release);
        return true;
    }

    /**
     * 获取第一个有效的元素
     * @note 请确保pop与peekSecond只在同一个线程下使用
     */
    bool peekFirst(T &value) {
        // 消费者本地快照
        size_t current_head = m_head.load(std::memory_order_relaxed);

        // 检查队列是否为空
        if (current_head == m_tail.load(std::memory_order_acquire)) {
            return false; // 队列空,弹出失败
        }

        // 从当前head指向的位置取出数据
        value = m_buffer[current_head];
        return true;
    }

    size_t size() const {
        size_t head = m_head.load(std::memory_order_acquire);
        size_t tail = m_tail.load(std::memory_order_acquire);
        if (tail >= head)
            return tail - head;
        else
            return m_capacity - head + tail;
    }

    size_t capacity() const {
        return m_capacity - 1;
    }

    int serial() const { return m_serial.load(std::memory_order_relaxed); }
    void addSerial() { m_serial.fetch_add(1); }

private:
    size_t nextIndex(size_t index) const {
        return (index + 1) % m_capacity;
    }

    const size_t m_capacity; // 环形缓冲区的总容量(包括浪费的一个位置)
    std::vector<T> m_buffer; // 数据缓冲区

    alignas(hardware_destructive_interference_size) std::atomic<size_t> m_head{0}; // 读索引(消费者使用)
    alignas(hardware_destructive_interference_size) std::atomic<size_t> m_tail{0}; // 写索引(生产者使用)
    std::atomic<int> m_serial{0};
};
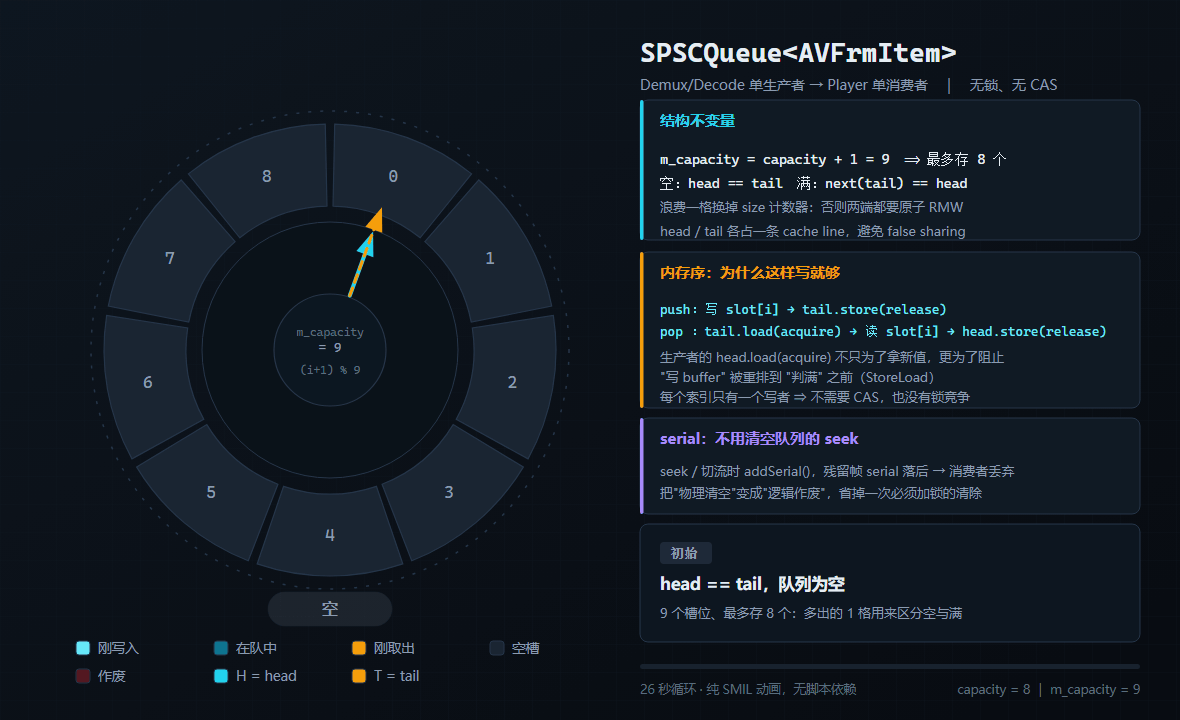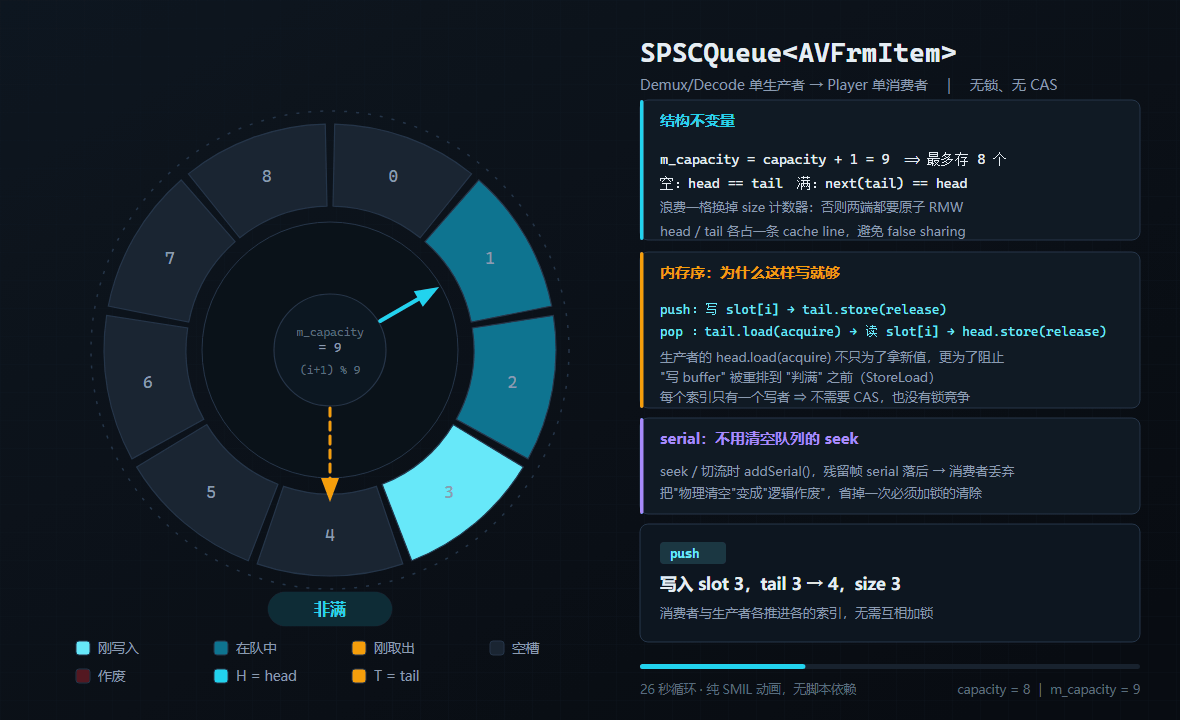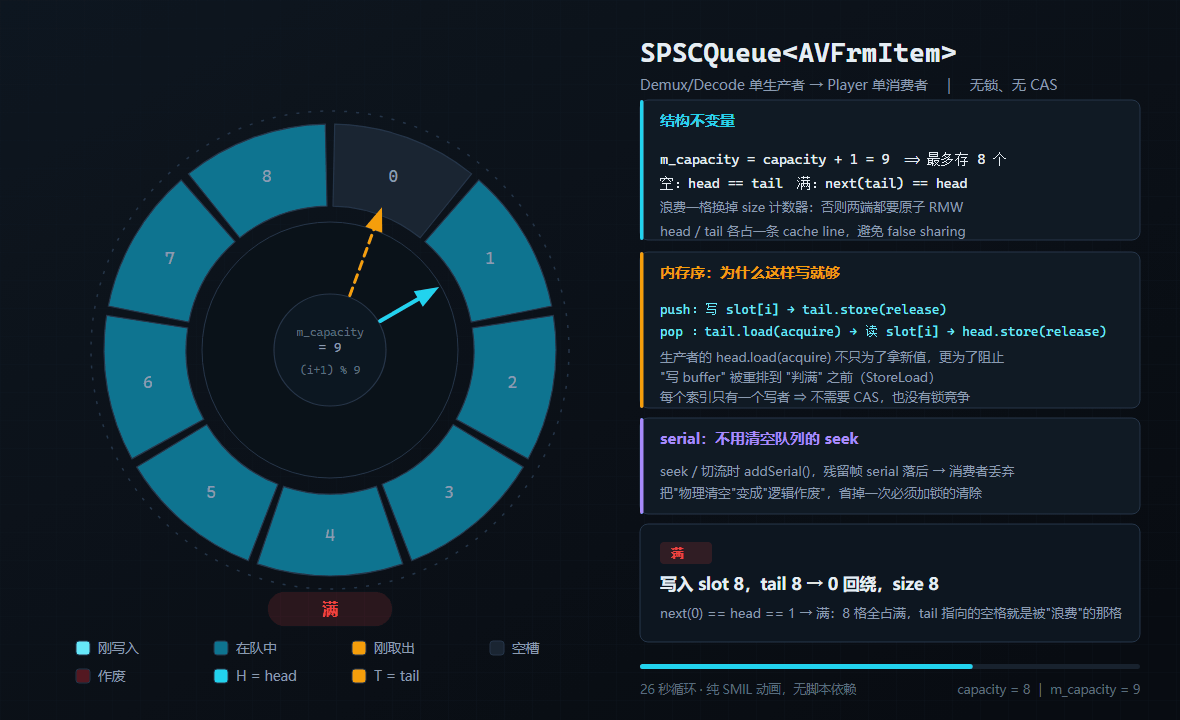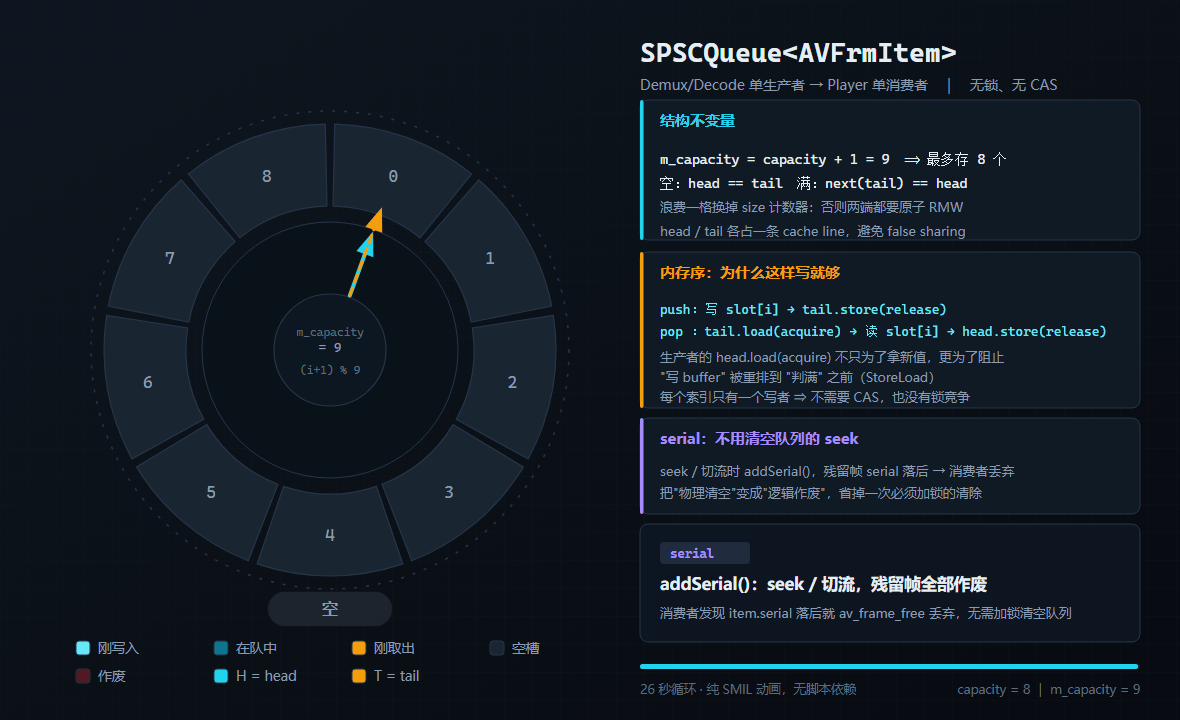
三角循环
m_capacity = capacity + 1
索引单调递增,nextIndex = (i+1) % m_capacity
空:head == tail
满:next(tail) == head
当每次填充环形缓冲区的时候,m_capacity 会自增,因此索引也会自增。
当填充即将满的时候,采用 % 运算,发现nextIndex = (i+1) % m_capacity
索引又回归到0了,新的包覆盖填充了最初始的一个。
| 变量 | 写者 | 读者 |
|---|---|---|
| m_head | 消费者(pop / peekFirst) | 生产者(判满) |
| m_tail | 生产者(push) | 消费者(判空) |
| m_buffer[i] | 生产者写 slot i,消费者读 slot i | —— |
推送到缓冲区里
    bool push(const T &value) {
        // 生产者本地快照
        size_t current_tail = m_tail.load(std::memory_order_relaxed);
        size_t next_tail = nextIndex(current_tail);

        // 检查队列是否已满
        if (next_tail == m_head.load(std::memory_order_acquire)) {
            return false; // 队列满,推送失败
        }

        // 将数据存入当前tail指向的位置
        m_buffer[current_tail] = value;

        // 发布tail的更新,确保前面的数据存储对消费者可见
        m_tail.store(next_tail, std::memory_order_release);
        return true;
    }
- 我们以
std::memory_order_relaxed 原子序从m_tail生产者读头来获得当前的生产序列id - 同理下一个写点是基于
nextIndex来计算出来的
注意,获得写位置都是基于内存序的,也就是说我们的m_tail &m_head 都是原子变量封装。
用硬件原子指令和内存序来保证共享索引的并发安全,避免数据竞争,同时通常比互斥锁更轻量,尤其是在音视频解码流水线上。
而pop和push的环节正好是对称的
    bool pop(T &value) {
        // 消费者本地快照
        size_t current_head = m_head.load(std::memory_order_relaxed);

        // 检查队列是否为空
        if (current_head == m_tail.load(std::memory_order_acquire)) {
            return false; // 队列空,弹出失败
        }

        // 从当前head指向的位置取出数据
        value = m_buffer[current_head];

        // 发布head的更新,告知生产者新的头部位置
        m_head.store(nextIndex(current_head), std::memory_order_release);
        return true;
    }
m_head 反过来用std::memory_order_relaxed内存序。
动图演示:
伪共享问题
    alignas(hardware_destructive_interference_size) std::atomic<size_t> m_head{0}; // 读索引(消费者使用)
    alignas(hardware_destructive_interference_size) std::atomic<size_t> m_tail{0}; // 写索引(生产者使用)
我们是通过硬件对齐来实现的。
我们做一个小demo来复现这种场景。
#1
using namespace std;
using namespace std::chrono;

// 缓存行大小: C++17 提供硬件推荐值, 否则回退到 64
#if defined(__cpp_lib_hardware_interference_size)
constexpr size_t CACHE_LINE = std::hardware_destructive_interference_size;
#else
constexpr size_t CACHE_LINE = 64;
#endif

constexpr long long ITERATIONS = 50'000'000;
前部分是一些定义。
-
如果没有定义
defined(__cpp_lib_hardware_interference_size)就自行设置缓存行大小。(目前是64推荐值) -
ITERATIONS为循环次数。
#2
/ -----------------------------------------------------------------
// 版本 1: 存在伪共享
//   a 和 b 紧挨着, 结构体只有 16 字节, 必然落在同一条 cache line
//   用 volatile 是为了强制编译器每次都真正写内存(防止写被合并/消除)
//   注意: volatile 不是同步原语, 这里只是为了制造真实的内存写流量
// -----------------------------------------------------------------
struct FalseSharing {
    volatile long long a = 0;
    volatile long long b = 0;
};

// -----------------------------------------------------------------
// 版本 2: 用 alignas 消除伪共享
//   a 和 b 各自 64 字节对齐, 强制独占不同 cache line
// -----------------------------------------------------------------
struct Padded {
    alignas(CACHE_LINE) volatile long long a = 0;
    alignas(CACHE_LINE) volatile long long b = 0;
};
我们做了两个版本的结构
-
伪共享:
volatile long long a和volatile long long b 紧紧相连,并未用alignas(CACHE_LINE)修饰
-
对齐
- 采用标识修饰。
#3
template <typename T>
double bench(T& data) {
    data.a = 0;
    data.b = 0;

    auto t0 = high_resolution_clock::now();

    // 线程 1 只写 a, 线程 2 只写 b —— 逻辑上毫无交集
    thread t1([&] { for (long long i = 0; i < ITERATIONS; ++i) data.a = i; });
    thread t2([&] { for (long long i = 0; i < ITERATIONS; ++i) data.b = i; });

    t1.join();
    t2.join();

    auto t1_end = high_resolution_clock::now();
    return duration<double>(t1_end - t0).count();
}
这是任务模板函数,调用时钟来锚准起点。
我们分别丢到俩线程里取跑ITERATIONS次赋值,最后计算占用时间
#main
int main() {
    FalseSharing fs;
    Padded       pd;

    // 预热, 消除首次运行的冷启动偏差
    bench(fs);
    bench(pd);

    // 多次运行取最优值, 减少调度噪声
    double best_fs = 1e9, best_pd = 1e9;
    for (int i = 0; i < 3; ++i) {
        best_fs = std::min(best_fs, bench(fs));
        best_pd = std::min(best_pd, bench(pd));
    }

    cout << "CACHE_LINE                  = " << CACHE_LINE << " bytes\n";
    cout << "sizeof(FalseSharing)        = " << sizeof(FalseSharing) << " bytes\n";
    cout << "sizeof(Padded)              = " << sizeof(Padded) << " bytes\n";
    cout << "&fs.a - &fs.b               = "
         << (reinterpret_cast<char*>(&fs.b) - reinterpret_cast<char*>(&fs.a)) << " bytes\n";
    cout << "&pd.a - &pd.b               = "
         << (reinterpret_cast<char*>(&pd.b) - reinterpret_cast<char*>(&pd.a)) << " bytes\n";
    cout << "-----------------------------------------------\n";
    cout << "FalseSharing: " << best_fs << " s\n";
    cout << "Padded      : " << best_pd << " s\n";
    cout << "Speedup     : " << best_fs / best_pd << "x\n";
    return 0;
}
#最后结果
CACHE_LINE                  = 64 bytes
sizeof(FalseSharing)        = 16 bytes
sizeof(Padded)              = 128 bytes
&fs.a - &fs.b               = 8 bytes      <-- 同一 cache line
&pd.a - &pd.b               = 64 bytes     <-- 不同 cache line
-----------------------------------------------
FalseSharing: 3.62 s
Padded      : 0.71 s
Speedup     : 5.1x
清晰可见,性能差了很多倍,这是因为:Cache line 是缓存同步的最小单位
现代 CPU 的 L1/L2/L3 缓存都按 cache line(x86/ARM 上通常是 64 字节)组织。读内存不是按变量读,而是把整条 cache line 拉进来;写也不是只写变量,而是操作整条 cache line。
硬解码
我们一路来到了解码部分
解码的核心不是把压缩数据变成图像,而是管理生命周期:解码器状态、参考帧队列.
解码器状态是什么,对于解码器的创建,我们通常要从流信息来获得创建解码器的状态上下文。
    m_streamIdx = stream->index;
    m_codecCtx = avcodec_alloc_context3(nullptr);
    ...
    int ret = avcodec_parameters_to_context(m_codecCtx, stream->codecpar);
    ...
    m_codec = avcodec_find_decoder(stream->codecpar->codec_id);
    if (!m_codec) {
        qDebug() << "无合适的解码器";
        return false;
    }

    m_codecCtx->pkt_timebase = stream->time_base;
    m_codecCtx->codec_id = m_codec->id;
首先向上溯源,获得解码器要从解码器id入手。
    // 获取各种流的idx
    for (unsigned int i = 0; i < m_formatCtx->nb_streams; ++i) {
        AVMediaType sType = m_formatCtx->streams[i]->codecpar->codec_type;
        if (sType == AVMEDIA_TYPE_VIDEO)
            m_videoIdx.push_back(i);
        else if (sType == AVMEDIA_TYPE_AUDIO)
            m_audioIdx.push_back(i);
        else if (sType == AVMEDIA_TYPE_SUBTITLE)
            m_subtitleIdx.push_back(i);
    }
从流信息类型获得流index,流信息里面储存着对应解码器codec_id。
生命周期
         init()                start()              stop()
未初始化 ────────→ 已初始化 ──────────→ 运行中 ──────────→ 已初始化
   ↑                   │                                    │
   └──── uninit() ─────┴────────────────────────────────────┘
整体是一个这样的状态机设计,准备播放的时候进行初始化,然后是运行。
如果是要更换视频源播放,就进行反初始化获得最开始的状态。
参考帧队列
解码器并非“一个包进、一个帧出”的管道。它内部有一个固定容量的参考帧集合(DPB)。
进出的速率和顺序都由它决定。这个集合的容量由 SPS 决定。
DPB(Decoded Picture Buffer)在 H.264 规范里同时有两种职责。
| 职责 | 服务对象 | 后果 |
|---|---|---|
| 参考帧存储 | 后续 P/B 帧的运动补偿 | 决定能参考多远(max_num_ref_frames) |
| 重排序缓冲 | 输出顺序 | 决定固定延迟(max_num_reorder_frames) |
如果出问题了会是这种问题:
- 参考帧不够 → 解错(花屏&报错);
- 重排序不够 → 只是延迟(帧会晚出)。
硬解码平台
我们还是以RK3568的开发板为例子。
- RK3568 的 VPU 能力##
| 项目 | 规格 |
|---|---|
| H.265/HEVC | 4K@60fps(含 Main10 10bit) |
| H.264/AVC | 4K@30fps(部分资料标 1080p@60,以具体 datasheet 为准) |
| VP9 | 4K@60fps |
| AVS2 | 4K@60fps |
| MPEG-1/2/4、VC-1、VP8 | 1080p@60 |
| AV1 解码 | 不支持 |
| 编码 | H.264/H.265 1080p@60 |
VPU
VPU(Vision/Video Processing Unit)是一类专门用于视觉或视频处理的处理器,常用于图像识别、视频编解码、AI 推理等场景。
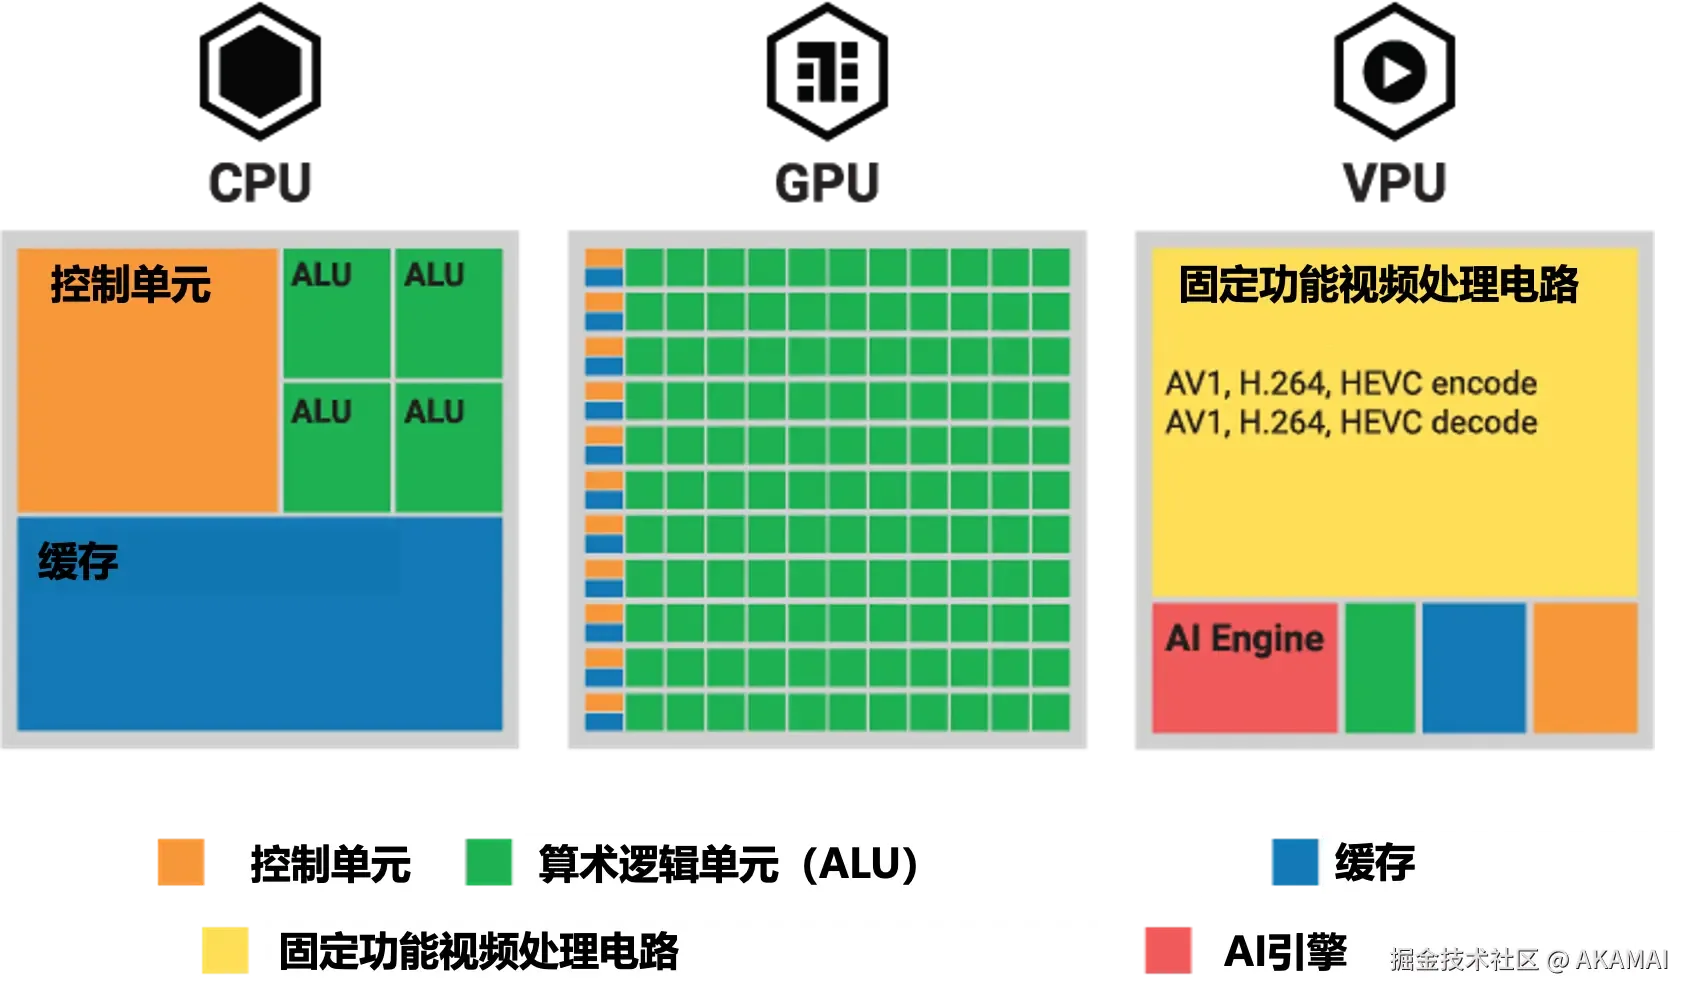
也就是说开发板上的VPU是一块独立控制视频处理的处理器,但准确地来讲作为处理器,这个名字还不是很恰当,它只是一块独立的硬件。只是硬处理了不同格式的封装。
硬件拓扑
展开图表
软硬件分层架构
展开图表
VPU宏观逻辑
展开图表
FFmpeg有一款独特的RockChip版本分支:FFmpeg-RockChip。
在硬解码的流程中,rkmpp并不直接使用AVPacket,而是需要处理过的解复用。
通过一张表我们可以看出是如何转化的,产物和目标是什么。
/* libavcodec/rkmppdec.c —— 简化 */
const FFCodec ff_h264_rkmpp_decoder = {
    .p.name         = "h264_rkmpp",
    .p.long_name    = NULL_IF_CONFIG_SMALL("Rockchip MPP H.264 decoder"),
    .p.type         = AVMEDIA_TYPE_VIDEO,
    .p.id           = AV_CODEC_ID_H264,
    .priv_data_size = sizeof(RKMPPDecContext),

    .init           = rkmpp_init_decoder,     /* 建 MppCtx */
    .close          = rkmpp_close_decoder,
    .send_packet    = rkmpp_send_packet,      /* AVPacket → MppPacket */
    .receive_frame  = rkmpp_receive_frame,    /* MppFrame → AVFrame */
    .flush          = rkmpp_flush,            /* avcodec_flush_buffers → MPP 重置 */

    .p.capabilities = AV_CODEC_CAP_DELAY | AV_CODEC_CAP_HARDWARE
                    | AV_CODEC_CAP_AVOID_PROBING,
    .p.pix_fmts     = (const enum AVPixelFormat[]){
                          AV_PIX_FMT_DRM_PRIME, AV_PIX_FMT_NONE },
    .hw_configs     = rkmpp_hw_configs,
};
rkmpp接受的是MppPacket。
同样地,硬解码从流上下文格式获得解码器id,但对应的是普通解码器id,rkmpp版本做了解码器id之间的映射。
static MppCodingType rkmpp_get_codingtype(AVCodecContext *avctx) {
    switch (avctx->codec_id) {
    case AV_CODEC_ID_H264: return MPP_VIDEO_CodingAVC;
    case AV_CODEC_ID_HEVC: return MPP_VIDEO_CodingHEVC;
    // ... 其他格式
    }
}
-
类似这一种:case AV_CODEC_ID_H264: return MPP_VIDEO_CodingAVC;
就做到了解码器之间的映射。
零拷贝包装
static int rkmpp_send_packet(AVCodecContext *avctx, const AVPacket *avpkt)
{
    MppPacket packet;
    mpp_packet_init(&packet, avpkt->data, avpkt->size);   /* 只包指针,不复制 */
    mpp_packet_set_pts(packet, avpkt->pts);

    while (r->mpi->decode_put_packet(r->mpp_ctx, packet) != MPP_OK)
        /* 输入队列满,等 */ ;

    mpp_packet_deinit(&packet);

    /* VPU 还在异步读这块内存,必须保住 avpkt */
    av_packet_unref(r->pkt);
    av_packet_ref(r->pkt, avpkt);
    return 0;
}
-
mpp_packet_init(&packet, avpkt->data, avpkt->size);完成了数据之间的交付,以及外层封装的改变,再就是封装层面的完善。 -
while (r->mpi->decode_put_packet(r->mpp_ctx, packet) != MPP_OK)这一步完成了
主动推向rkmpp解码器的过程,其中:
r 是解码器的私有上下文指针,通常指向 RKMPPDecContext 结构体。
RKMPPDecContext *r = avctx->priv_data;
通过私有上下文 r 拿到 MPP API 表 mpi ,再对 MPP 上下文 mpp_ctx 调用 decode_put_packet。
decode_put_packet把mppPacket送入硬件解码器,此时需要保住avpkt不要被释放。
因为while是尝试推进一包到解码器。只有尝试成功的时候,这个r->pkt 容器旧内容需要被解除引用,换到新的包。
r->pkt 留着的是上一次发包内容的引用,所以等到新的包到来,它需要unref然后再ref 新的包裹。
接下来会走的路径
 ├─ rkmpp_send_packet()
 │   ├─ mpp_packet_init(&packet, pkt->data, pkt->size)   ← 只包指针,不拷贝
 │   ├─ mpp_packet_set_pts(packet, pkt->pts)
 │   └─ mpi->decode_put_packet(mpp_ctx, packet)
在调用rkmpp_send_packet() 之后,会依旧根据封装层面数据进行初始化,设置pts
└─ mpi->decode_put_packet(mpp_ctx, packet)
 │       │
 │       │  ═══ 以下过程处于 librockchip_mpp.so 里 ═══
 │       ├─ ① 码流解析(mpp_parser)
 │       │     · 找 NALU 边界(按长度前缀或 start code)
 │       │     · 解析 SPS/PPS,提取宽高、DPB 容量、POC 类型
 │       │     · 解析 slice header,确定这是第几个 slice、属于哪一帧
 │       │
 │       ├─ ② DPB 管理
 │       │     · 判断当前帧是 I/P/B,需要哪些参考帧
 │       │     · 决定哪个 buffer 可以复用、哪个必须保留
 │       │
 │       ├─ ③ 命令构造
 │       │     · 把 H.264 的语法结构翻译成 VPU 的寄存器值序列
 │       │     · 填 MppDevCmd:码流地址、输出地址、参考帧地址、QP 表…
 │       │
 │       └─ ④ ioctl(/dev/mpp_service, MPP_IOC_MSG, &msg)   ← 进内核
 │           │
 │           │  ═══ 内核态 ═══
 │           ├─ mpp_service.c 分发到 mpp_rkvdec2.c
 │           ├─ IOMMU 映射,把虚拟地址换成 VPU 能用的物理地址
 │           ├─ 写寄存器、启动 VPU
 │           └─ 挂起等中断
接下来就到了VPU启动的环节了。
VPU,启动!
VPU开始着手处理发来的被翻译的命令集合。
展开图表
从图里面可以看出,在AVPacket被包装成mppPacket之后,要主动进行一次memcpy拷贝到dmabuf。
dmabuf并不是在dma上,它是一个概念,它实际上是在内存的一个区域里。
为什么我们要搬运一次?
通常来讲,硬件设备访问内存要做一些步骤:
/* 1. pin 住页(禁止换出) */
get_user_pages(addr, npages, FOLL_WRITE, pages, NULL);

/* 2. 逐页建立 IOMMU 映射 */
for (i = 0; i < npages; i++)
    iommu_map(domain, iova + i * PAGE_SIZE,
              page_to_phys(pages[i]), PAGE_SIZE, ...);

/* 3. 把 iova 写进 VPU 寄存器,启动 */
/* 4. 等中断 */
/* 5. 拆除 */
iommu_unmap(domain, iova, npages * PAGE_SIZE);
for (i = 0; i < npages; i++)
    put_page(pages[i]);
***IOVA(I/O Virtual Address,I/O 虚拟地址)就是“设备视角看到的地址”*** 。设备发起 DMA 时用的不是 CPU 的虚拟地址,也不一定是物理地址,而是 IOVA;IOMMU 再把这个 IOVA 翻译成主机物理地址 HPA。
-
pin住内存页,防止页换出,换出的时候我们找到的就不是内容了,而是来路不明的内容。
-
做映射:pin住之后,逐页建立 IOMMU 映射。
-
通过iova写进VPU寄存器,然后进行解码处理。
但是这样做有一定代价:
-
物理页不连续
进程虚拟地址(连续):
  0x7f2000 ────────────────────────> 0x7fec80

物理页(散落):
  0x1a3f2000  0x88c01000  0x2b7e5000  0x0f9a3000 ...
      ↑ 13 个不同的 4KB 页
进程掌握着连续的虚拟地址,而真实的物理页是散落的,要完成的话得一步一步收集散落的地址并逐个建立表项。
- 页的换出、迁移:
普通 malloc 的页是可回收的:
- 内存压力大时被 swap;
- 碎片整理时被迁移(compaction);
副作用:钉住的内存无法参与内存回收和压缩,这一页的内存暂时冻结了.
高出mempcy()的成本
| 步骤 | 50KB(13 页)的耗时 |
|---|---|
get_user_pages |
~10 μs(每页 0.5~1μs,要遍历页表 + 加 refcount) |
| IOMMU map 13 页 | ~5~10 μs |
| IOMMU unmap | ~5 μs |
put_page × 13 |
~5 μs |
| 合计 | ~25~30 μs |
| 对比:memcpy 50KB | ~5 μs 代价:(10 GB/s 的 DDR 带宽) |
每帧都要重做
av_read_frame(fmt, pkt);
/* 内部 av_new_packet —— 每次都新 malloc,物理页每次都不同 */
这下基于上面的情况要变的更糟糕了,每次newpacket需要malloc新的内存,新的内存就要被pin住一整个页,会有很多散乱的页被pin住.
所以我们映射的方案根本不如memcpy.
数据传输
我们通过memcpy把pkt传入dmabuf,数据在 DDR 的 dma-buf 区域;接下来是
- MPP 把这块内存的 IOVA 写进 VPU 寄存器并置 START
- VPU 用 DMA 经 IOMMU 翻译后直接读 DDR
- VPU 只“读”这块内存,不“掌控”它——所有权在 MPP,VPU 是个临时使用者。
解码产物
展开图表
如果使用h264_rkmpp,我们不必手动创建dmabuf,内部实现已经帮我们处理好了dmabuf
整个流程数据的移动在这里
dma-buf A(stream buffer,512KB,fd=20)
   ┌──────────────────┐
   │ H.264 码流        │
   └────────┬─────────┘
            │ VPU DMA 读
            ↓
          VPU 解码
            │ VPU DMA 写
            ↓
   ┌──────────────────┐
   │ NV12 像素         │  ← dma-buf B(3.1MB,fd=21)
   └──────────────────┘
我们手动memcpy搬运到了dma-buf A区,经过VPU的解码,产物置于dma-buf的 B区。
解码过程我们不做过多叙述,内部像是看作黑盒一样的硬件处理过程,毕竟VPU本身就是处理音视频功能的硬件。
好了,AVFrame们先在dmabuf B里待一会吧,下期我们再把他们搬出来做事情。
